如何用 AI 撰写文献综述:2026 年工作流
阅读 40 篇论文并不难。在脑海中同时理清 40 篇论文,从而说出该领域真正的共识,这才是难点。
这正是 AI 工作空间能够真正提供帮助的任务。但这也是一项有着严格界限的任务。规范文献综述的标准关乎方法和可追溯性,而没有任何工具可以代您提供这两者。
本指南将介绍哪些地方的帮助是切实的、哪些责任仍由您承担,并提供一个能够产出站得住脚的草稿的工作流。
文献综述的真正目的
文献综述不是一堆摘要的堆砌。它是对一系列研究工作的论证。它阐明了哪些观点已成定论、哪些研究结果存在冲突,以及还有哪些领域尚未有人涉足。
读者想从中了解 3 件事:该领域研究了什么?是如何研究的?这些研究共同说明了什么?
以下的每一个步骤都是为了回答其中一个问题。而逐篇总结论文无法回答其中的任何一个。这就是为什么逐篇罗列的文献综述读起来像是一个清单,而不是一个论证。
报告标准的要求
在动笔之前,非常值得去阅读一下这里最广泛使用的标准,因为它明确了评审文献综述的依据。
The PRISMA statement — Preferred Reporting Items for Systematic reviews and Meta-Analyses — describes itself as "a guideline designed to improve the reporting of systematic reviews."
注意“报告”(reporting)这个词。该声明自身的总结对其范围有着明确的界定。PRISMA“为作者提供了如何完整报告为何进行系统评价的指导和示例。”同一句话继续写道:“使用了什么方法,以及发现了什么结果。”
这句话正是此处使用 AI 的全部边界条件。工具可以帮助您了解论文说了什么。而您的方法之所以具有可报告性,是因为您做出并记录了决策,这部分工作完全属于作者。
PRISMA 2020 是主要指南。它“由各种 PRISMA 扩展版进行补充”,声明指出这些扩展版“为不同类型或不同方面的系统评价报告提供指导”。例如,范围综述(scoping reviews)就有其专属的扩展版。
并非每篇文献综述都是系统评价,大多数课程作业也不是。但其报告逻辑适用于任何文献综述:说明原因、说明方法、说明发现。
AI 在哪些方面有帮助,哪些方面没有
明确这一点可以免去日后的麻烦,特别是当您所在的机构要求在文献综述旁附带一份声明时。
| 任务 | 实际帮助 | 谁承担最终责任 |
|---|---|---|
| 寻找论文 | 有限——工作空间只读取您提供的内容 | 您负责构建语料库 |
| 提取方法、样本和研究结果 | 强大,可同时跨多个文档进行 | 您负责对照原文进行核实 |
| 构建对比矩阵 | 强大 | 您负责决定列属性 |
| 发现研究之间的分歧 | 擅长发现,不擅长裁决 | 您负责判断哪个研究结果成立 |
| 撰写综合论述 | 可作为初稿参考 | 您负责撰写论证 |
| 引用和引文 | 必须逐一检查 | 始终由您负责 |
第一行是人们最容易出错的地方。AI 工作空间是基于您上传的文档进行工作的。它不会代您检索付费订阅数据库,这意味着您文献综述的覆盖范围完全取决于您收集了什么。
这绝非一个小问题。覆盖范围是评审人员对任何文献综述提出质疑的首要问题。这也是整个流程中毫无疑问需要手动完成的部分。
首先构建语料库
在打开任何工具之前先做这件事。语料库决定了文献综述后续的一切。
将问题定义得足够具体,以便能够回答。“远程工作与生产力”是一个主题;而“自 2020 年以来,完全远程工作对知识型岗位实测生产力的影响”则是一个有明确界限的问题。
直接检索您所在领域的数据库。记录下使用了哪些数据库、哪些检索词以及哪个日期范围——在撰写方法部分时,您会需要这三项内容,而事后重新构建这些信息会非常痛苦。
应用纳入和排除标准,并记录每个阶段的数量。找到了多少条记录,筛选后剩下多少条,完整阅读了多少篇。这正是 PRISMA 要求您报告的轨迹。
然后将 PDF 导出到一个文件夹中。该文件夹就是您的输入源。
关于文件质量的一个实用建议。没有文本层的扫描版 PDF 提取效果很差,混合了清晰文件和扫描文件的语料库会产生参差不齐的结果。在假定整套文件都可读之前,先检查其中几篇,并在有出版商版本的情况下替换掉扫描版。
构建综合矩阵
综合矩阵是将一堆论文转化为文献综述的中间产物。行代表来源,列代表主题或变量,单元格则记录每个来源对每个主题的阐述。
横向阅读一行可以了解一篇论文。纵向阅读一列可以了解该领域对某个问题的立场——而这正是您实际要撰写的内容。
矩阵还能让“缺失”显现出来,而纯文本则做不到这一点。某一列中的空白区域标志着一组从未探讨过该问题的论文。这种空白往往是整个研究中最具发表价值的发现,而当您按顺序阅读时,它几乎是不可见的。
将其构建为电子表格,而不是文档。您需要反复对其进行排序、筛选和重新排序,而表格对这些操作的承载能力是文本文件无法比拟的。
步骤 1:上传语料库并定义列属性
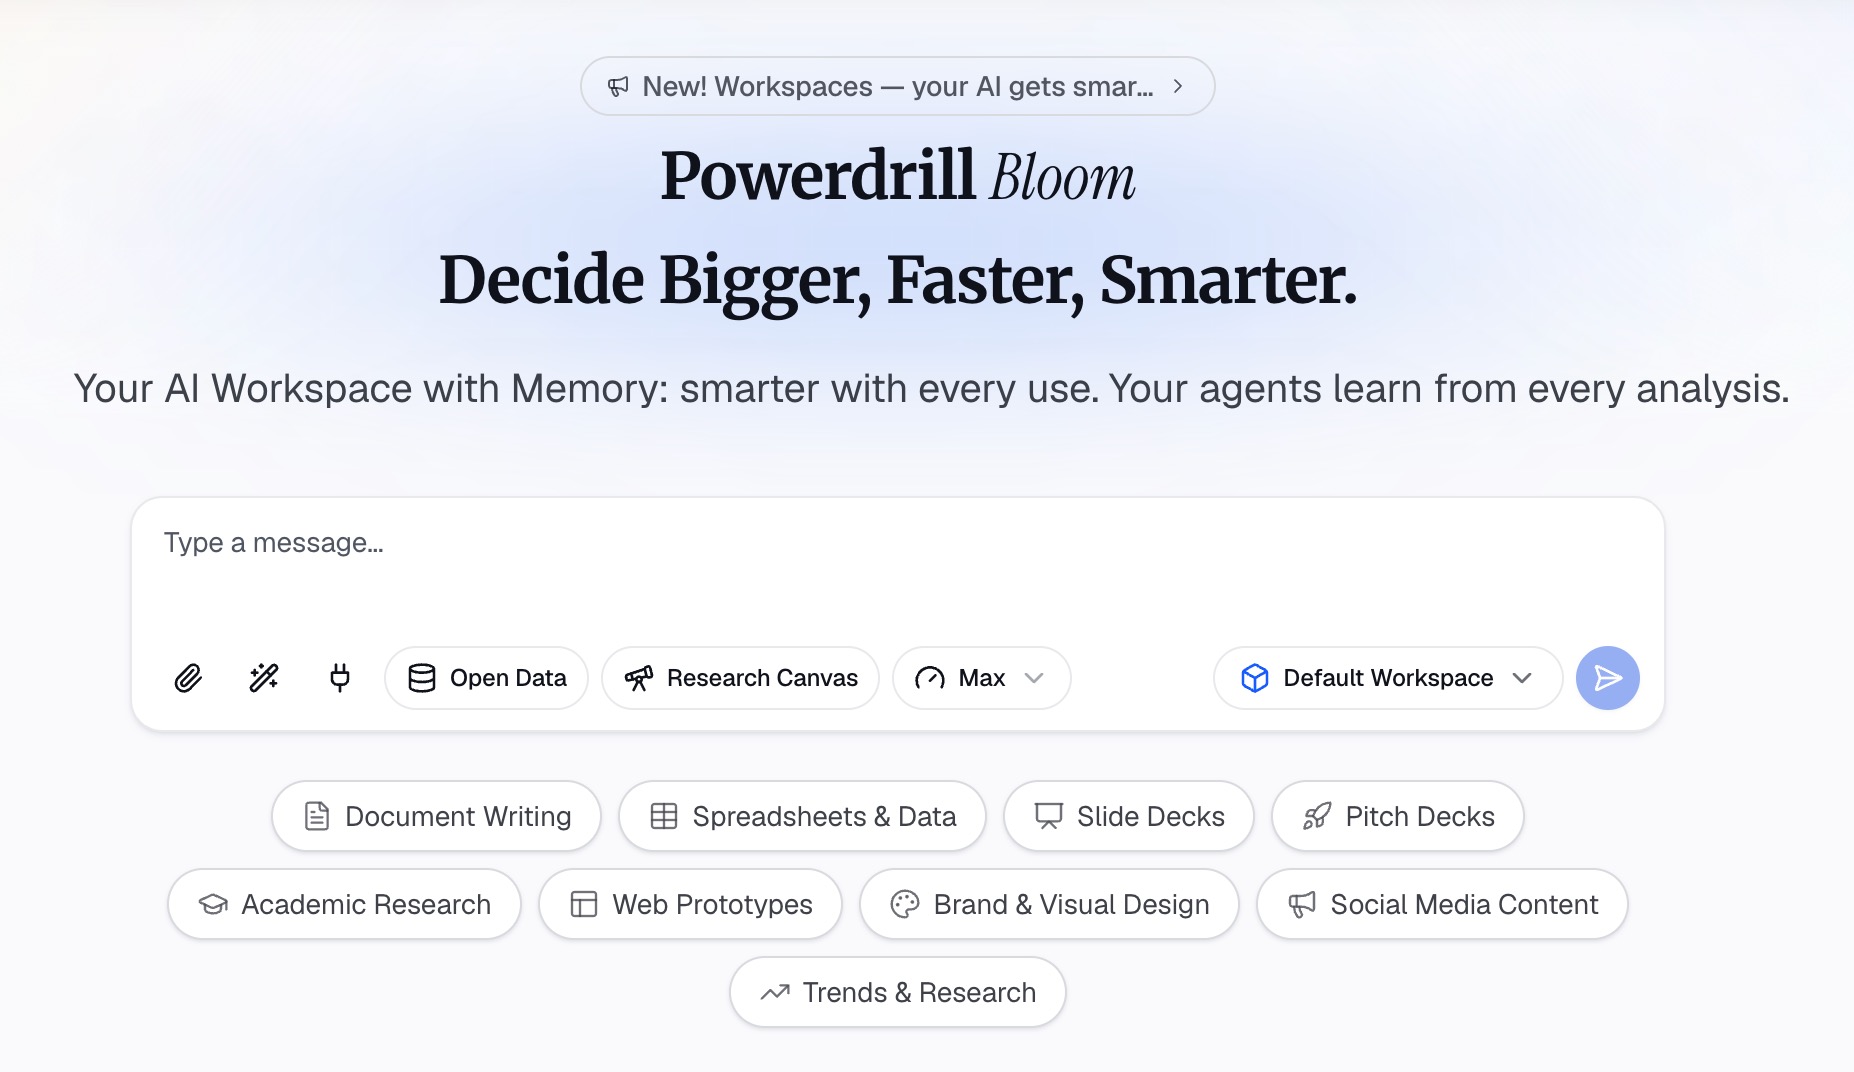
打开 Powerdrill Bloom 并将 PDF 作为集合上传。用自然语言描述您想要的矩阵,并明确命名各列。
常用的默认列包括作者和年份、研究问题、方法、样本和背景、主要发现以及声明的局限性。添加一到两个针对您特定问题的列——例如您关注的变量,或每篇论文所使用的理论框架。
亲自定义列属性是至关重要的一步。它们体现了您对这场辩论核心的理解,而通用的列设置只会产出平庸的文献综述。
步骤 2:对照原文核实每一行
将生成的矩阵视为具有已知失效模式的草稿。提取在处理明确表述时是可靠的,但在处理任何含蓄暗示的内容时可靠性较低。
对照论文本身检查样本量、日期和效应方向。相反的符号或误读的样本量会扩散到您的综合论述中,并且以后很难被发现。
特别注意局限性列。作者会在不同的地方阐述局限性——有时在讨论部分,有时在脚注中——而这正是提取最容易遗漏内容的地方。
步骤 3:纵向阅读各列并指出分歧
现在,发挥该矩阵的作用。一次看一列,并思考该领域集体表达了什么。
让工作空间根据在每个主题上的立场对来源进行分组,并标记研究结果冲突的地方。冲突是这里最有价值的产出——共识很容易写,而分歧才是文献综述体现其价值的地方。
然后亲自审视这些冲突。两项研究产生分歧是因为方法、样本、时期还是定义的不同?这个问题是文献综述的思想核心,需要由您来回答。
正在处理大量的 PDF 语料库?立即体验 Powerdrill Bloom。
将矩阵转化为文字论述
矩阵是脚手架,而不是文献综述本身。将前者转化为后者遵循一个可靠的模式。
按主题组织,绝不要按论文组织。每个部分针对一个问题,报告现有研究对此的阐述,并为每个论点引用多个来源。
每个段落应以论点开头,而不是以引用开头。“3 项研究发现生产力没有差异”读起来像是一个论证。而“Smith (2023) 发现……”读起来则像是一个清单。
明确处理冲突。当研究存在分歧时,直接指出,然后解释可能的原因。一篇抹平分歧的文献综述,其价值远不如一篇梳理出分歧脉络的综述。
以研究空白收尾。还有什么尚未被研究,为什么这很重要?这正是文献综述值得被引用的原因,它直接源自您矩阵中的空白单元格。
| 矩阵元素 | 转化为文字论述 |
|---|---|
| 一列 | 一个主题章节 |
| 纵向列中的共识 | 带有多个引用的论点 |
| 纵向列中的冲突 | 解释来源为何存在差异的段落 |
| 空白区域 | 结论中的研究空白 |
| 局限性列 | 您对证据质量的评估 |
对于阅读步骤本身,这里有一份关于如何自动将 50 页的 PDF 报告总结为核心见解的演练。对于直接处理文档,这里有一份与 PDF 对话的指南。
保留一份站得住脚的记录
有两份文档与文献综述本身同样重要,而且在进行过程中随时记录要比事后重新构建容易得多。
第一份是检索记录。包括查询的数据库、确切的检索字符串、日期范围以及每个筛选阶段的记录数量。这能让读者判断覆盖范围,也是当结论令人惊讶时,评审人员首先检查的部分。
第二份是关于工具参与情况的记录。哪些步骤使用了 AI 工作空间,以及您做了什么来验证每个步骤的输出。现在许多机构都会直接要求提供此项内容,将其写下来可以将一个尴尬的问题转化为两行字的简单回答。
这两份文档都不需要太复杂。对于大多数项目来说,单页内容就足够涵盖这两者,而且共享文档比私人文档效果更好。
除了合规之外,这还有一个实际的好处。在提取 6 周后,您将不记得某个特定的样本量是来自摘要还是方法部分。而这份记录无需重新打开 40 篇 PDF 就能回答这个问题。
| 记录内容 | 为什么需要它 |
|---|---|
| 数据库和检索字符串 | 方法部分,以及应对任何关于覆盖范围的质疑 |
| 每个筛选阶段的数量 | 重建筛选过程 |
| 纳入和排除标准 | 解释为什么某篇已知的论文没有被纳入 |
| 哪些步骤使用了工具 | 信息披露要求 |
| 验证了什么以及如何验证 | 应对对特定数字的质疑 |
什么时候该工作流不适用
值得指出的是,在某些情况下,上述方法反而会增加工作量,而不是减轻负担。
对 5 或 6 篇论文进行综述不需要矩阵。您完全可以在脑海中理清 6 篇论文,为它们搭建脚手架的成本远超其带来的收益。
如果综述的论证真正关乎某一个理论传统,而不是累积的研究结果,那么从制表中获益较少。提取在处理可衡量的论点时效果很好,但在处理解释性立场时效果较差。
元分析的要求比这里描述的任何内容都要严格。效应量、异质性和偏倚风险评估都遵循既定的方案,提取步骤需要满足这些方案,而不是使用通用的列设置。
如果您所在的领域需要注册方案,请在提取开始前进行注册。事后注册会违背其初衷。
常见错误
逐篇总结论文。这是最常见的结构性失败。它产出的是一份冠以错误标题的有注释的书目。
让工具来设定主题。通用的列会产生通用的章节。这些列其实就是您论证的大纲形式。
因为输出看起来很笃定就跳过验证。流畅的提取和正确的提取是两码事,两者的差异会在您的方法部分中显现出来。
未能记录检索过程。您未纳入的论文也是方法的一部分,事后重新构建检索很少能产生完全相同的列表。
未经检查就直接采用引用。每条参考文献都必须追溯到源头。这是不可妥协的,而且比起出错的后果,这花不了多少时间。
将分歧视为噪音。在大多数文献中,冲突的研究结果才是提供最多信息的部分。
先写引言。文献综述的框架应该源自矩阵所展示的内容,而不是先于它。在阅读之前撰写的引言往往会宣告一个证据并不支持的结论。
过度收集。40 篇精选的论文胜过通过广泛检索收集的 100 篇。每增加一个来源都会消耗验证时间,而边缘性的来源很少能改变论点。
把研究空白部分留到最后并草草了事。研究空白通常是综述中被引用最多的部分,它值得您花心思撰写,而不是在半夜草草写下一个段落。
快速参考
| 阶段 | 产出 | AI 节省的时间 |
|---|---|---|
| 定义问题 | 一个有界限、可回答的问题 | 无——这完全取决于您 |
| 检索与筛选 | 一个 PDF 文件夹及检索记录 | 无——直接检索数据库 |
| 提取 | 填充完整的综合矩阵 | 大幅节省 |
| 验证 | 经核对的矩阵 | 无——这是为上一行付出的代价 |
| 综合 | 分组的立场和指出的冲突 | 大幅节省 |
| 撰写 | 综述本身 | 适度,作为初稿 |
| 引用 | 经核实的参考文献 | 无 |
从最后一列可以明显看出规律。帮助主要集中在中间环节,即工作量巨大的部分。而开头和结尾仍需手动完成,因为那是需要发挥判断力的地方。
针对该领域的专用工具,这里有学术 AI 工具以及用于 PDF 数据提取和分析的 AI 工具的汇总。
常见问题解答
AI 能帮我写文献综述吗?
一旦您收集并验证了材料,它就可以帮您起草各个章节,而且它在跨多篇论文的提取和对比方面确实非常强大。但有 3 件事仍由您决定:设定研究问题、保证覆盖范围以及对准确性承担责任。评审人员会在这 3 个方面对您进行严格考量。
什么是综合矩阵?
一种行代表来源、列代表主题或变量的表格。横向阅读一行可以总结一篇论文;纵向阅读一列可以展示该领域对某个问题的看法。它是从阅读过渡到写作的标准中间步骤。
撰写文献综述允许使用 AI 吗?
政策因机构和期刊而异,现在许多机构和期刊都要求披露如何使用 AI。请检查适用于您的指南,并记录哪些步骤涉及使用工具。无论如何,对准确性承担的责任始终由作者承担。
PRISMA 有什么要求?
PRISMA 是系统评价的报告指南。它要求作者完整报告进行综述的原因、使用的方法以及发现的结果。其扩展版涵盖了其他综述类型,例如范围综述。
文献综述应该包含多少个来源?
这没有固定的数量,取决于研究范围和领域。更重要的是您的检索和筛选过程是有记录且站得住脚的。读者应该能够清楚地知道哪些内容被纳入了,哪些内容被排除了。
来源:PRISMA 声明,prisma-statement.org,包括 PRISMA 2020 及其扩展版。