Jak analizować dane ze skali Likerta: krok po kroku
Aby przeanalizować dane ze skali Likerta, najpierw ustal, czy oceniasz pojedyncze pozycje typu Likerta, czy wielopozycyjną skalę Likerta. Podsumuj pojedyncze pozycje za pomocą liczebności, odsetków, mediany oraz dominanty i przedstaw je na wykresach słupkowych. Łącz kilka pozycji w jeden wynik skali tylko wtedy, gdy mierzą one ten sam koncept – w takim przypadku możesz użyć średnich i odchyleń standardowych.
Ten poradnik wyjaśnia tę różnicę, pokazuje, jak kodować i oczyszczać odpowiedzi oraz jak krok po kroku analizować dane za pomocą AI lub w programie Excel. Obejmuje również tworzenie wykresów, porównania grup, praktyczny przykład oraz błędy, które prowadzą do mylących wyników.
Czym są dane ze skali Likerta
Dane Likerta pochodzą z pytań ankietowych, w których respondenci określają swój stopień zgody, poziom zadowolenia lub częstotliwość występowania danego zjawiska. Typowa pięciostopniowa pozycja obejmuje odpowiedzi od „Zdecydowanie się nie zgadzam” do „Zdecydowanie się zgadzam”.
Zespół ds. ewaluacji na Uniwersytecie Arizony (University of Arizona) wprowadza przydatne rozróżnienie między dwoma rodzajami danych. „Skala Likerta to wielopozycyjne psychometryczne narzędzie oceny, które mierzy dany koncept za pomocą serii pojedynczych pytań”. Z kolei pozycje typu Likerta to „pojedyncze pytania mierzone przy użyciu różnych rodzajów skal odpowiedzi”.
Ta różnica ma większe znaczenie niż jakikolwiek wzór. Boone i Boone zwrócili na to uwagę w artykule z 2012 roku w Journal of Extension. Napisali, że oba te przypadki „wymagają unikalnych procedur analizy danych, w wyniku czego często dochodzi do nadużyć i/lub błędów”.
W ankiecie pracowniczej pozycje typu Likerta mogą być raportowane pojedynczo: „Wdrożenie przygotowało mnie do mojej roli”, „Poleciłbym ten produkt” i tak dalej. W badaniu naukowym można połączyć kilka powiązanych pozycji w jedną skalę Likerta. Wiedza o tym, z którym typem masz do czynienia, podpowiada, jakich statystyk użyć.
Pozycje typu Likerta a skale Likerta
Strona Uniwersytetu Arizony przedstawia procedury sugerowane przez Boone'a i Boone'a dla każdego rodzaju danych:
| Miara | Pozycje typu Likerta | Wyniki skali Likerta |
|---|---|---|
| Tendencja centralna | Mediana lub dominanta | Średnia |
| Zmienność | Liczebności | Odchylenie standardowe |
| Związki | Tau-b lub tau-c Kendalla | r Pearsona |
| Inne statystyki | Chi-kwadrat | ANOVA, test t, regresja |
W przypadku pojedynczych pozycji autorzy strony wypowiadają się wprost. Powinny być one „analizowane jako osobne pozycje przy użyciu technik sortowania i grupowania, takich jak tabele rozkładu liczebności lub pomoce wizualne, np. wykresy słupkowe”. Dodają również: „Obliczanie średnich nie jest właściwe dla tego typu danych, chociaż dane można analizować przy użyciu mediany lub dominanty”.
W przypadku skal wielopozycyjnych zasady są łagodniejsze. Ta sama strona podaje, że zagregowany wynik „może być traktowany jako dane ciągłe i oceniany przy użyciu wszystkich miar tendencji centralnej: dominanty, mediany lub średniej”.
Praktyczna zasada jest prosta. Jeśli raportujesz jedno pytanie, przedstaw jego rozkład. Jeśli raportujesz wynik zbudowany z kilku pytań, możesz podać jego średnią.
Zanim zaczniesz: zakoduj i oczyść odpowiedzi
Eksporty z ankiet mogą zapisywać odpowiedzi jako tekst. Analiza jest łatwiejsza, gdy każda odpowiedź ma przypisaną liczbę, dlatego zacznij od ich zakodowania.
- Przypisz kody po kolei. W przypadku pięciostopniowej skali zgody użyj wartości 1 dla „Zdecydowanie się nie zgadzam” aż do 5 dla „Zdecydowanie się zgadzam”.
- Zachowaj etykiety. Kody służą do sortowania i zliczania. W raporcie nadal należy używać słów, które widzieli respondenci.
- Odwróć pozycje o odwróconym znaczeniu. Jeśli pytanie jest sformułowane przecząco, odwróć jego kody przed połączeniem go z innymi pozycjami.
- Postępuj odpowiednio z pustymi odpowiedziami i opcją „Nie dotyczy”. Pomiń je w obliczeniach i podaj, ile ich było.
- Sprawdź długość skali. Nie łącz pozycji pięciostopniowych i siedmiostopniowych w jednej tabeli.
Przygotuj krótki klucz kodowy zawierający brzmienie każdego pytania, kody oraz wszelkie odwrócenia. Dzięki temu analiza będzie powtarzalna w kolejnym kwartale.
Jak analizować dane ze skali Likerta
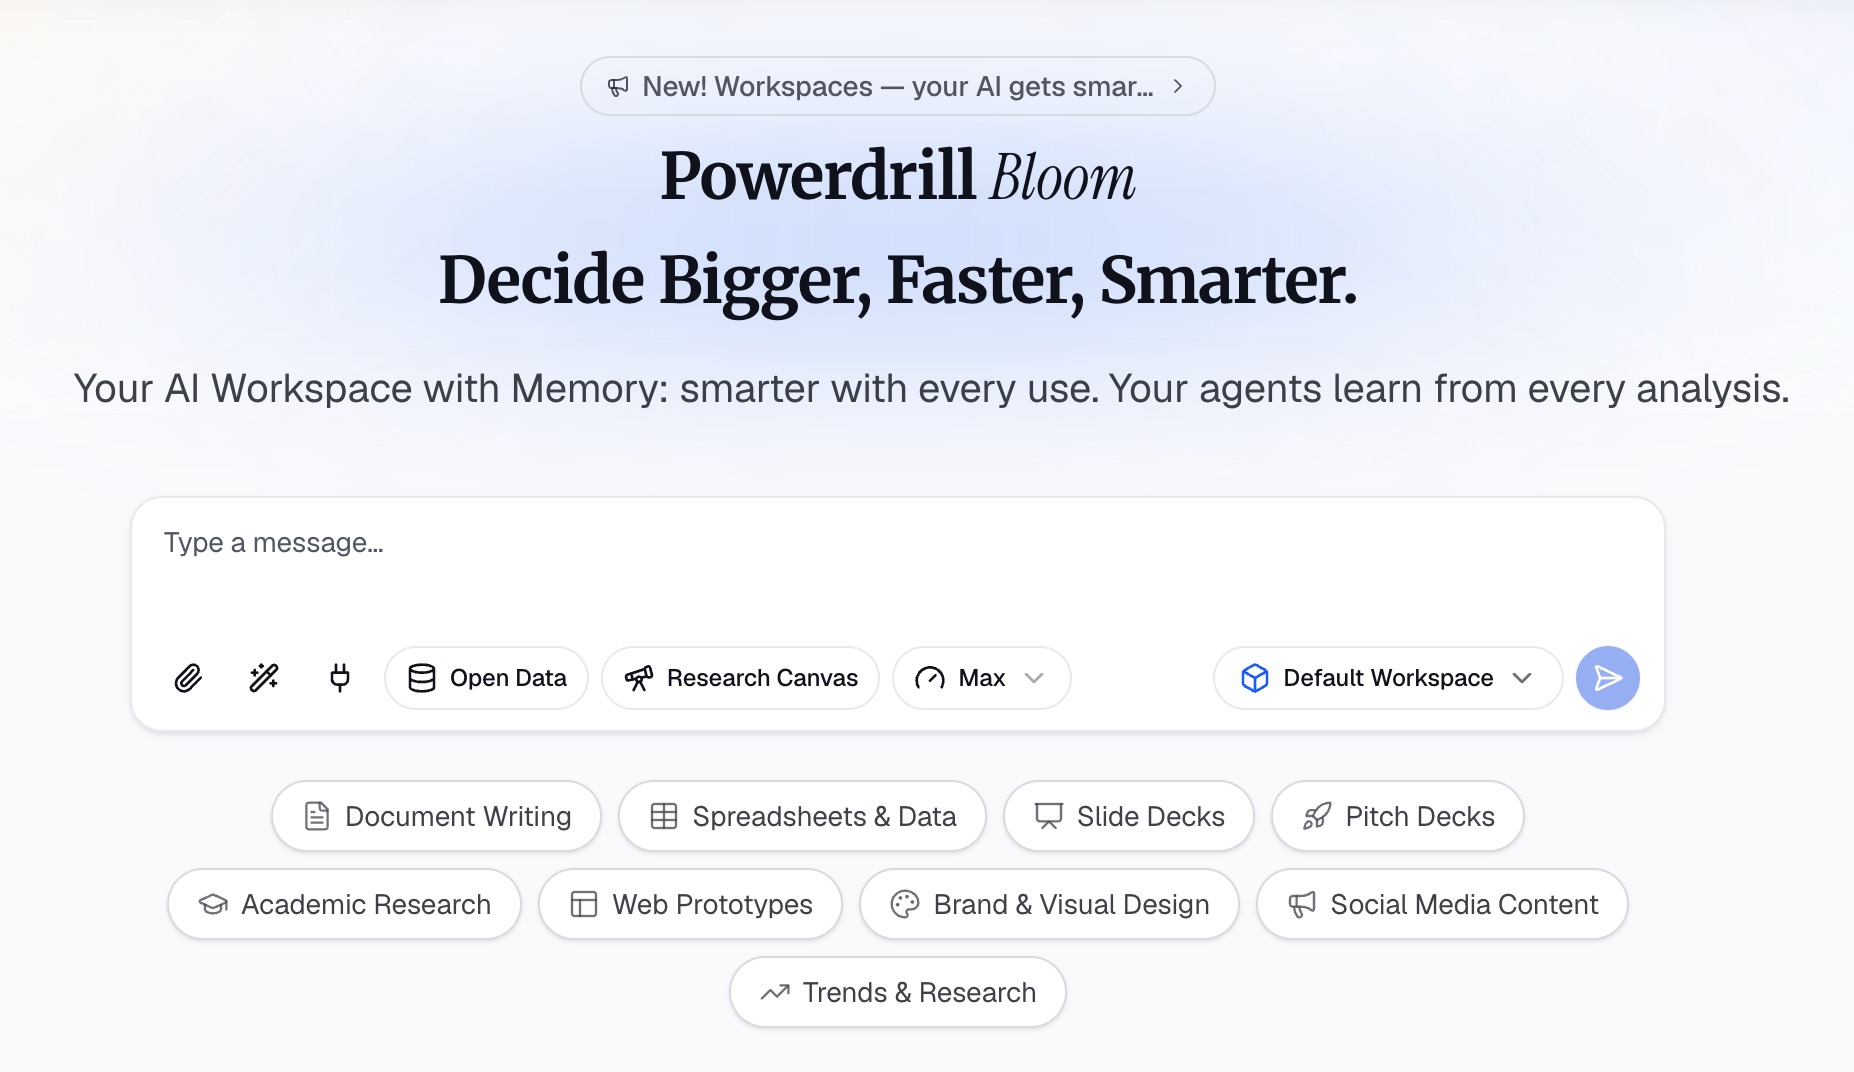
Trzy poniższe kroki wykorzystują narzędzie Powerdrill Bloom, ale to samo podejście sprawdzi się w każdym programie, który odczytuje wyeksportowane dane z ankiety. Instrukcję dla programu Excel znajdziesz w następnej sekcji.
Krok 1: Prześlij wyeksportowane dane z ankiety i zakoduj odpowiedzi
Wyeksportuj odpowiedzi ze swojego narzędzia ankietowego jako plik CSV lub Excel, zachowując układ: jeden wiersz na respondenta i jedna kolumna na pytanie. Prześlij plik i opisz skalę naturalnym językiem, na przykład: „Kolumny od D do K używają pięciostopniowej skali zgody”.
Poproś o zakodowanie odpowiedzi tekstowych od 1 do 5 i wskaż wszelkie pozycje o odwróconym znaczeniu, aby zostały odwrócone. Następnie poproś o podanie liczby ważnych odpowiedzi dla każdej pozycji oraz liczby odpowiedzi pustych lub „Nie dotyczy”. Przed przejściem dalej porównaj te liczby z łączną liczbą odpowiedzi w swoim narzędziu ankietowym.
Krok 2: Podsumuj każdą pozycję za pomocą liczebności, mediany i dominanty
Poproś o tabelę liczebności dla każdej pozycji: liczbę i odsetek dla każdej opcji odpowiedzi. Dodaj medianę i dominantę dla każdej pozycji – są to miary, które Boone i Boone sugerują dla pojedynczych pytań.
Niektóre zespoły raportują również wskaźnik top-two-box, czyli odsetek osób, które wybrały odpowiedź „Zgadzam się” lub „Zdecydowanie się zgadzam”. Jest on łatwy w interpretacji i pasuje do celów takich jak ten z przykładu Uniwersytetu Arizony: „90% studentów deklaruje pewność siebie”.
Jeśli niektóre pozycje tworzą skalę, poproś o obliczenie zagregowanego wyniku dla każdego respondenta, a następnie średniej i odchylenia standardowego tego wyniku. Umieść tabele dla poszczególnych pozycji obok niego, aby czytelnicy mogli zobaczyć, które pytania wpływają na ogólny wynik.
Krok 3: Przedstaw wyniki na wykresie i porównaj grupy
Poproś o wykres słupkowy odsetka odpowiedzi dla każdej pozycji, uporządkowany od największego do najmniejszego poziomu zgody. Nasza strona bar graph maker szczegółowo opisuje proces tworzenia wykresów.
Przed udostępnieniem wykresu porównaj go z tabelą liczebności. Słupki dla każdej pozycji powinny sumować się do 100%, a etykiety powinny odpowiadać sformułowaniom, które widzieli respondenci.
Następnie porównaj grupy istotne dla Twoich decyzji, takie jak działy, regiony czy segmenty klientów. Poproś o rozkład procentowy każdej pozycji w podziale na grupy, aby grupy o różnych wielkościach pozostały porównywalne. Na koniec poproś o krótkie pisemne podsumowanie wskazujące pozycje o najniższym poziomie zgody.
Jak analizować dane Likerta w programie Excel
Excel dobrze radzi sobie z analizą skali Likerta po zakodowaniu odpowiedzi. Załóżmy, że kody danej pozycji znajdują się w zakresie B2:B201, po jednym dla każdego respondenta.
Zlicz każdą odpowiedź. Firma Microsoft opisuje funkcję LICZ.JEŻELI jako sposób na zliczanie komórek spełniających określone kryterium, o składni LICZ.JEŻELI(zakres; kryteria). Zlicz każdą opcję za pomocą formuł od =LICZ.JEŻELI(B2:B201;1) do =LICZ.JEŻELI(B2:B201;5).
Zamień liczebności na odsetki. Podziel każdą liczbę przez liczbę ważnych odpowiedzi, =ILE.LICZB(B2:B201). Sformatuj wyniki jako procenty.
Znajdź medianę. Użyj formuły =MEDIANA(B2:B201). Microsoft zwraca uwagę na szczegół, który ma znaczenie dla kodów Likerta. „Jeśli w zbiorze znajduje się parzysta liczba liczb, funkcja MEDIANA oblicza średnią z dwóch środkowych liczb”. Wynik taki jak 3,5 oznacza, że środek wypada między dwiema odpowiedziami, należy więc podać obie etykiety.
Znajdź dominantę. Odczytaj ją z tabeli liczebności: jest to opcja o najwyższej liczbie wskazań. Jeśli dwie opcje uzyskają taki sam wynik, podaj obie.
Oblicz wskaźnik top-two-box. Użyj formuły =(LICZ.JEŻELI(B2:B201;4)+LICZ.JEŻELI(B2:B201;5))/ILE.LICZB(B2:B201), aby uzyskać odsetek osób, które odpowiedziały „Zgadzam się” lub „Zdecydowanie się zgadzam”.
Tabela przestawna (PivotTable) może wykonać to samo zliczanie dla wielu pozycji jednocześnie. Umieść pozycję w wierszach, odpowiedź w kolumnach, a liczbę odpowiedzi w wartościach. Następnie przedstaw wartości jako procent sumy wiersza.
Praktyczny przykład
Oto przykładowy wynik dla jednej pięciostopniowej pozycji uzyskany od 200 pracowników. Pozycja brzmi: „Szkolenie wdrożeniowe przygotowało mnie do mojej roli”. Liczby są przykładowe i nie pochodzą z rzeczywistego badania.
| Odpowiedź | Kod | Liczba wskazań | Odsetek |
|---|---|---|---|
| Zdecydowanie się nie zgadzam | 1 | 10 | 5% |
| Nie zgadzam się | 2 | 20 | 10% |
| Neutralna | 3 | 30 | 15% |
| Zgadzam się | 4 | 90 | 45% |
| Zdecydowanie się zgadzam | 5 | 50 | 25% |
Na podstawie tej tabeli:
- Mediana: Zgadzam się. Po uporządkowaniu od 1 do 5, zarówno setna, jak i sto pierwsza odpowiedź mieszczą się w kategorii „Zgadzam się”. Pierwsze trzy opcje obejmują łącznie 60 odpowiedzi, a opcja „Zgadzam się” kolejne 90.
- Dominanta: Zgadzam się. Ma najwyższą liczbę wskazań (90).
- Top-two-box: 70%. To suma 45% odpowiedzi „Zgadzam się” i 25% „Zdecydowanie się zgadzam”.
- Bottom-two-box: 15%. To suma 5% odpowiedzi „Zdecydowanie się nie zgadzam” i 10% „Nie zgadzam się”.
Jasno sformułowany wniosek brzmiałby: „70% respondentów zgodziło się, że wdrożenie ich przygotowało, a 15% było przeciwnego zdania”. Takie zdanie jest bardziej użyteczne dla menedżera niż stwierdzenie, że „średnia wyniosła 3,75”, i jest zgodne z podejściem opartym na liczebnościach dla pojedynczych pozycji.
Jak przedstawiać dane Likerta na wykresach
Wykresy słupkowe dobrze sprawdzają się w przypadku pojedynczych pozycji i są jedną z pomocy wizualnych wymienianych na stronie Uniwersytetu Arizony. Przy wielu pozycjach jednocześnie skumulowany wykres słupkowy pozwala przedstawić pełny rozkład każdej z nich w jednym wierszu.
Jeden z układów jest szczególnie zalecany w literaturze statystycznej. Heiberger i Robbins argumentują na łamach Journal of Statistical Software: „Zalecamy rozbieżne skumulowane wykresy słupkowe jako podstawową technikę graficznej prezentacji skali Likerta i pokrewnych”. W tym układzie odpowiedzi negatywne (brak zgody) rozciągają się na lewo od linii środkowej, a pozytywne (zgoda) na prawo.
Aby stworzyć prostą wersję takiego wykresu w programie Excel, wprowadź odsetki odpowiedzi negatywnych jako liczby ujemne, a pozytywnych jako dodatnie. Następnie wstaw skumulowany wykres słupkowy i posortuj pozycje według łącznego poziomu zgody. Udział odpowiedzi neutralnych można podzielić na pół wzdłuż linii środkowej lub przedstawić w osobnej kolumnie.
Oznacz każdy słupek jego wartością procentową lub przynajmniej dodaj etykiety dla łącznej sumy odpowiedzi na „tak” i na „nie”. Dzięki temu dwie najważniejsze liczby znajdą się bezpośrednio na wykresie.
Niezależnie od wybranego wykresu, zachowaj tę samą kolejność odpowiedzi dla wszystkich pozycji. Użyj jednej palety kolorów dla braku zgody i innej dla zgody, aby czytelnicy mogli szybko przeskanować wzrokiem wykres. Nasz poradnik dotyczący zamiany nieuporządkowanych danych z ankiet w czytelne wykresy omawia dopracowywanie wykresów w bardziej szczegółowy sposób.
Porównywanie grup
Wyniki ankiet często skłaniają do porównań: ten zespół kontra tamten, ten rok kontra ubiegły. W przypadku pojedynczych pozycji typu Likerta porównuj ze sobą rozkłady procentowe, a nie średnie.
Przedstawiaj porównania jako odsetki w ramach każdej grupy, ponieważ grupy rzadko są tej samej wielkości. Zespół liczący 12 osób i zespół liczący 200 osób można sprawiedliwie porównać tylko za pomocą udziałów procentowych.
Jeśli potrzebujesz testu statystycznego, tabela Boone'a i Boone'a wskazuje test chi-kwadrat dla pozycji typu Likerta. Dla wyników skali wymienia testy ANOVA, testy t oraz regresję. Małe grupy sprawiają, że każdy test jest mniej wiarygodny, dlatego zawsze podawaj wielkość grup obok wyników.
Oto przykładowe zobrazowanie. W pytaniu o wdrożenie zgodziło się 72% ze 150-osobowego zespołu sprzedaży w porównaniu do 58% z 50-osobowego zespołu wsparcia. Rzetelny sposób raportowania to: „Zgodziło się 72% osób z działu sprzedaży (n = 150) oraz 58% z działu wsparcia (n = 50)”. Dzięki temu czytelnicy mogą ocenić różnicę, mając na uwadze wielkość grup, a nie tylko dwa suche odsetki.
Raportowanie wyników
Wytyczne Uniwersytetu Arizony zawierają wyraźne ostrzeżenie przed stosowaniem średnich. Określają one jako „niewłaściwe przypisywanie wartości liczbowych do skali odpowiedzi na etapie analizy”. Wniosek, przed którym ostrzegają, to na przykład: „studenci są średnio pewni siebie”.
Przejrzysty raport może zawierać cztery części dla każdej pozycji lub tematu:
- Dokładne brzmienie pytania oraz opcje odpowiedzi.
- Liczbę ważnych odpowiedzi oraz liczbę odpowiedzi pustych.
- Rozkład w formie tabeli lub wykresu.
- Jedno proste zdanie podsumowujące odsetki top-two-box i bottom-two-box.
If you track the same item over time, keep the wording and the response options identical. A changed word or an added option breaks the comparison with earlier rounds, so note any change in the report.
W przypadku pełnego opracowania nasz poradnik dotyczący tworzenia raportu z wyników ankiety omawia strukturę i układ dokumentu. Jeśli wyniki mają zostać zaprezentowane na spotkaniu, poradnik dotyczący prezentacji wyników ankiety pomoże Ci przygotować slajdy.
Typowe błędy, których należy unikać
- Wyciąganie średniej z pojedynczych pozycji. Średnia wynosząca 3,4 ukrywa fakt, czy respondenci są podzieleni, czy też ich opinie są umiarkowane, a powyższe wytyczne odradzają takie podejście.
- Mieszanie statystyk dla pojedynczych pozycji i całych skal. Używaj liczebności i median dla pojedynczych pozycji, a średnich wyłącznie dla wyników wielopozycyjnych skal.
- Pomijanie odwracania kodowania. Negatywnie sformułowane pytanie, którego kodowanie nie zostanie odwrócone, zniekształci ogólny wynik skali.
- Ciche pomijanie opcji neutralnej. Jeśli wykluczasz odpowiedź „Neutralna” ze wskaźnika top-two-box, poinformuj o tym w raporcie.
- Porównywanie bezwzględnych liczb między grupami. Zamiast tego używaj odsetków w ramach każdej grupy.
- Nadinterpretacja małych prób. Wzrost poziomu zgody z 60% do 70% niewiele znaczy, jeśli na pytanie odpowiedziało tylko 10 osób.
Gdy Twoje odpowiedzi spłyną w postaci nieuporządkowanego pliku, możesz wypróbować Powerdrill Bloom, aby je zakodować oraz automatycznie stworzyć tabele liczebności i wykresy.
Najczęściej zadawane pytania
Jak analizować dane ze skali Likerta?
Zakoduj odpowiedzi jako liczby, a następnie podsumuj każdą pozycję za pomocą liczebności, odsetków, mediany i dominanty. Przedstaw rozkłady na wykresach słupkowych. Jeśli kilka pozycji tworzy jedną skalę, połącz je w jeden wynik i podaj jego średnią oraz odchylenie standardowe.
Czy można wyciągać średnią z danych ze skali Likerta?
W przypadku pojedynczych pozycji typu Likerta wytyczne oparte na pracy Boone'a i Boone'a odradzają stosowanie średnich i zalecają medianę lub dominantę. W przypadku wyników wielopozycyjnej skali Likerta średnia i odchylenie standardowe są jak najbardziej odpowiednie.
Jaki wykres jest najlepszy dla danych ze skali Likerta?
Wykresy słupkowe dobrze sprawdzają się w przypadku pojedynczych pozycji. Przy wielu pozycjach skumulowany wykres słupkowy pozwala pokazać pełny rozkład każdej z nich. Heiberger i Robbins zalecają rozbieżne skumulowane wykresy słupkowe jako podstawowy sposób prezentacji skal Likerta.
Czy dane ze skali Likerta są porządkowe czy przedziałowe?
Pojedyncze pozycje typu Likerta to uporządkowane kategorie, dlatego wytyczne oparte na pracy Boone'a i Boone'a sugerują stosowanie mediany i dominanty. Wyniki zbudowane z kilku pozycji mogą być traktowane jako dane ciągłe, zgodnie z informacjami na stronie Uniwersytetu Arizony.
Jak analizować dane ze skali Likerta w programie Excel?
Użyj funkcji LICZ.JEŻELI, aby zliczyć każdą odpowiedź, podziel wynik przez ILE.LICZB, aby uzyskać odsetki, i użyj funkcji MEDIANA do wyznaczenia środkowej odpowiedzi. Tabela przestawna (PivotTable) pozwala zliczyć wiele pozycji jednocześnie. Następnie na podstawie odsetków utwórz skumulowany wykres słupkowy.
Źródła: Boone and Boone, Analyzing Likert Data, Journal of Extension (2012) · University of Arizona, The Analysis of Scale Data · Heiberger and Robbins, Design of Diverging Stacked Bar Charts for Likert Scales, Journal of Statistical Software · Microsoft Support, funkcja LICZ.JEŻELI · Microsoft Support, funkcja MEDIANA.