Hoe schrijf je een literatuuronderzoek met AI: Een workflow voor 2026
Het lezen van veertig artikelen is niet het moeilijkste deel. Veertig artikelen tegelijkertijd in je hoofd houden, zodat je kunt zeggen waar het vakgebied het eigenlijk over eens is, dat is het moeilijke deel.
Dat is de taak waarbij een AI-werkruimte echt helpt. Het is ook een taak met een strikte grens. De normen voor een literatuuronderzoek gaan over methode en traceerbaarheid, en geen enkele tool biedt een van beide namens jou.
Deze gids behandelt waar de hulp reëel is, waar de verantwoordelijkheid bij jou blijft liggen, en een workflow die een verdedigbaar concept oplevert.
Waar het literatuuronderzoek eigenlijk voor dient
Een literatuuronderzoek is geen stapel samenvattingen. Het is een betoog over een verzameling werk. Wat is er vastgesteld, waar spreken de bevindingen elkaar tegen, en wat heeft nog niemand onderzocht.
De lezer wil er drie dingen uit halen. Wat heeft het vakgebied bestudeerd, hoe is het bestudeerd, en waar telt dat allemaal bij op?
Elke onderstaande stap bestaat om een van die vragen te beantwoorden. Een opeenvolgende samenvatting van elk artikel beantwoordt geen van deze vragen. Dat is waarom een literatuuronderzoek dat artikel voor artikel afgaat, leest als een opsomming in plaats van een betoog.
Wat de rapportagerichtlijnen vereisen
Het is de moeite waard om de meest gebruikte richtlijn hier te lezen voordat je iets schrijft, omdat het verduidelijkt waarop een literatuuronderzoek wordt beoordeeld.
De PRISMA-verklaring — Preferred Reporting Items for Systematic reviews and Meta-Analyses — omschrijft zichzelf als "een richtlijn die is ontworpen om de rapportage van systematische reviews te verbeteren."
Let op het woord rapportage. De eigen samenvatting van de verklaring is specifiek over de reikwijdte ervan. PRISMA "biedt auteurs richtlijnen en voorbeelden over hoe ze volledig kunnen rapporteren waarom een systematische review is uitgevoerd." Dezelfde zin vervolgt: "welke methoden zijn gebruikt en welke resultaten zijn gevonden."
Die zin is de volledige randvoorwaarde voor het gebruik van AI hier. Een tool kan je helpen te zien wat de artikelen zeggen. Je methode wordt rapporteerbaar door de beslissingen die je hebt genomen en vastgelegd, wat werk is dat bij de auteur ligt.
PRISMA 2020 is de belangrijkste richtlijn. Deze wordt "aangevuld met verschillende PRISMA-extensies", waarvan de verklaring zegt dat ze "richtlijnen bieden voor de rapportage van verschillende typen of aspecten van systematische reviews." Scoping reviews hebben bijvoorbeeld hun eigen extensie.
Niet elk literatuuronderzoek is een systematische review, en de meeste studieopdrachten zijn dat ook niet. Maar de rapportagelogica is van toepassing op elk literatuuronderzoek: vertel waarom, vertel hoe, vertel wat je hebt gevonden.
Waar AI helpt en waar niet
Hier nauwkeurig in zijn bespaart later problemen, vooral als je instelling een openbaarmakingsverklaring vereist naast het literatuuronderzoek.
| Taak | Realistische hulp | Wie verantwoordelijk blijft |
|---|---|---|
| Artikelen vinden | Beperkt — een werkruimte leest wat je erin invoert | Jij stelt het corpus samen |
| Methode, steekproef en bevindingen extraheren | Sterk, over veel documenten tegelijk | Jij verifieert aan de hand van de bron |
| Een vergelijkingsmatrix bouwen | Sterk | Jij bepaalt de kolommen |
| Tegenstrijdigheden tussen onderzoeken opsporen | Sterk in het naar boven halen, zwak in het beoordelen | Jij beoordeelt welke bevinding standhoudt |
| De synthesetekst schrijven | Nuttig als eerste concept | Jij schrijft het betoog |
| Citaten en bronvermeldingen | Moeten individueel worden gecontroleerd | Jij, elke keer weer |
De eerste rij is degene waar mensen de fout in gaan. Een AI-werkruimte werkt op basis van de documenten die je uploadt. Het doorzoekt geen abonnementsdatabase namens jou, wat betekent dat de dekking van je literatuuronderzoek volledig wordt bepaald door wat je hebt verzameld.
Dat is geen klein voorbehoud. Dekking is het eerste waar een beoordelaar vraagtekens bij zet bij elk literatuuronderzoek. Het is ook het enige deel van dit proces dat ondubbelzinnig handmatig is.
Eerst het corpus samenstellen
Doe dit voordat je een tool opent. Het corpus bepaalt alles wat daarop volgt in een literatuuronderzoek.
Definieer de vraag nauw genoeg om beantwoordbaar te zijn. "Thuiswerken en productiviteit" is een onderwerp; "gemeten productiviteitseffecten van volledig thuiswerken in kennisrollen sinds 2020" is een vraag met een duidelijke grens.
Doorzoek rechtstreeks de databases van je vakgebied. Leg vast welke databases, welke zoektermen en welk datumbereik je hebt gebruikt — je hebt ze alle drie nodig voor de methodensectie, en het achteraf reconstrueren ervan is een drama.
Pas in- en uitsluitingscriteria toe en noteer het aantal in elke fase. Hoeveel resultaten zijn er gevonden, hoeveel bleven er over na de screening, hoeveel zijn er volledig gelezen. Dit is precies het spoor dat PRISMA je vraagt te rapporteren.
Exporteer de PDF's vervolgens naar één map. Die map is je invoer.
Een praktische opmerking over de bestandskwaliteit. Gescande PDF's zonder tekstlaag laten zich slecht extraheren, en een corpus dat schone en gescande bestanden mengt, levert ongelijkmatige resultaten op. Controleer er een paar voordat je ervan uitgaat dat de hele set leesbaar is, en vervang de gescande versies waar een uitgeversversie beschikbaar is.
De synthesematrix bouwen
Een synthesematrix is het tussenproduct dat een stapel artikelen verandert in een literatuuronderzoek. Rijen zijn bronnen, kolommen zijn thema's of variabelen, en cellen bevatten wat elke bron over elk thema zegt.
Als je een rij horizontaal leest, krijg je één artikel. Als je een kolom verticaal leest, krijg je het standpunt van het vakgebied over één vraag — en dat is waar je eigenlijk over schrijft.
De matrix maakt ook afwezigheid zichtbaar, wat lopende tekst niet doet. Een leeg gebied in een kolom markeert een reeks artikelen die iets nooit hebben behandeld. Die leegte is vaak de meest publiceerbare observatie van de hele oefening, en is vrijwel onzichtbaar wanneer je opeenvolgend leest.
Bouw het als een spreadsheet in plaats van een document. Je zult het herhaaldelijk sorteren, filteren en opnieuw sorteren, en een tabel verdraagt dat op een manier die een tekstbestand niet toestaat.
Stap 1: Upload het corpus en definieer de kolommen
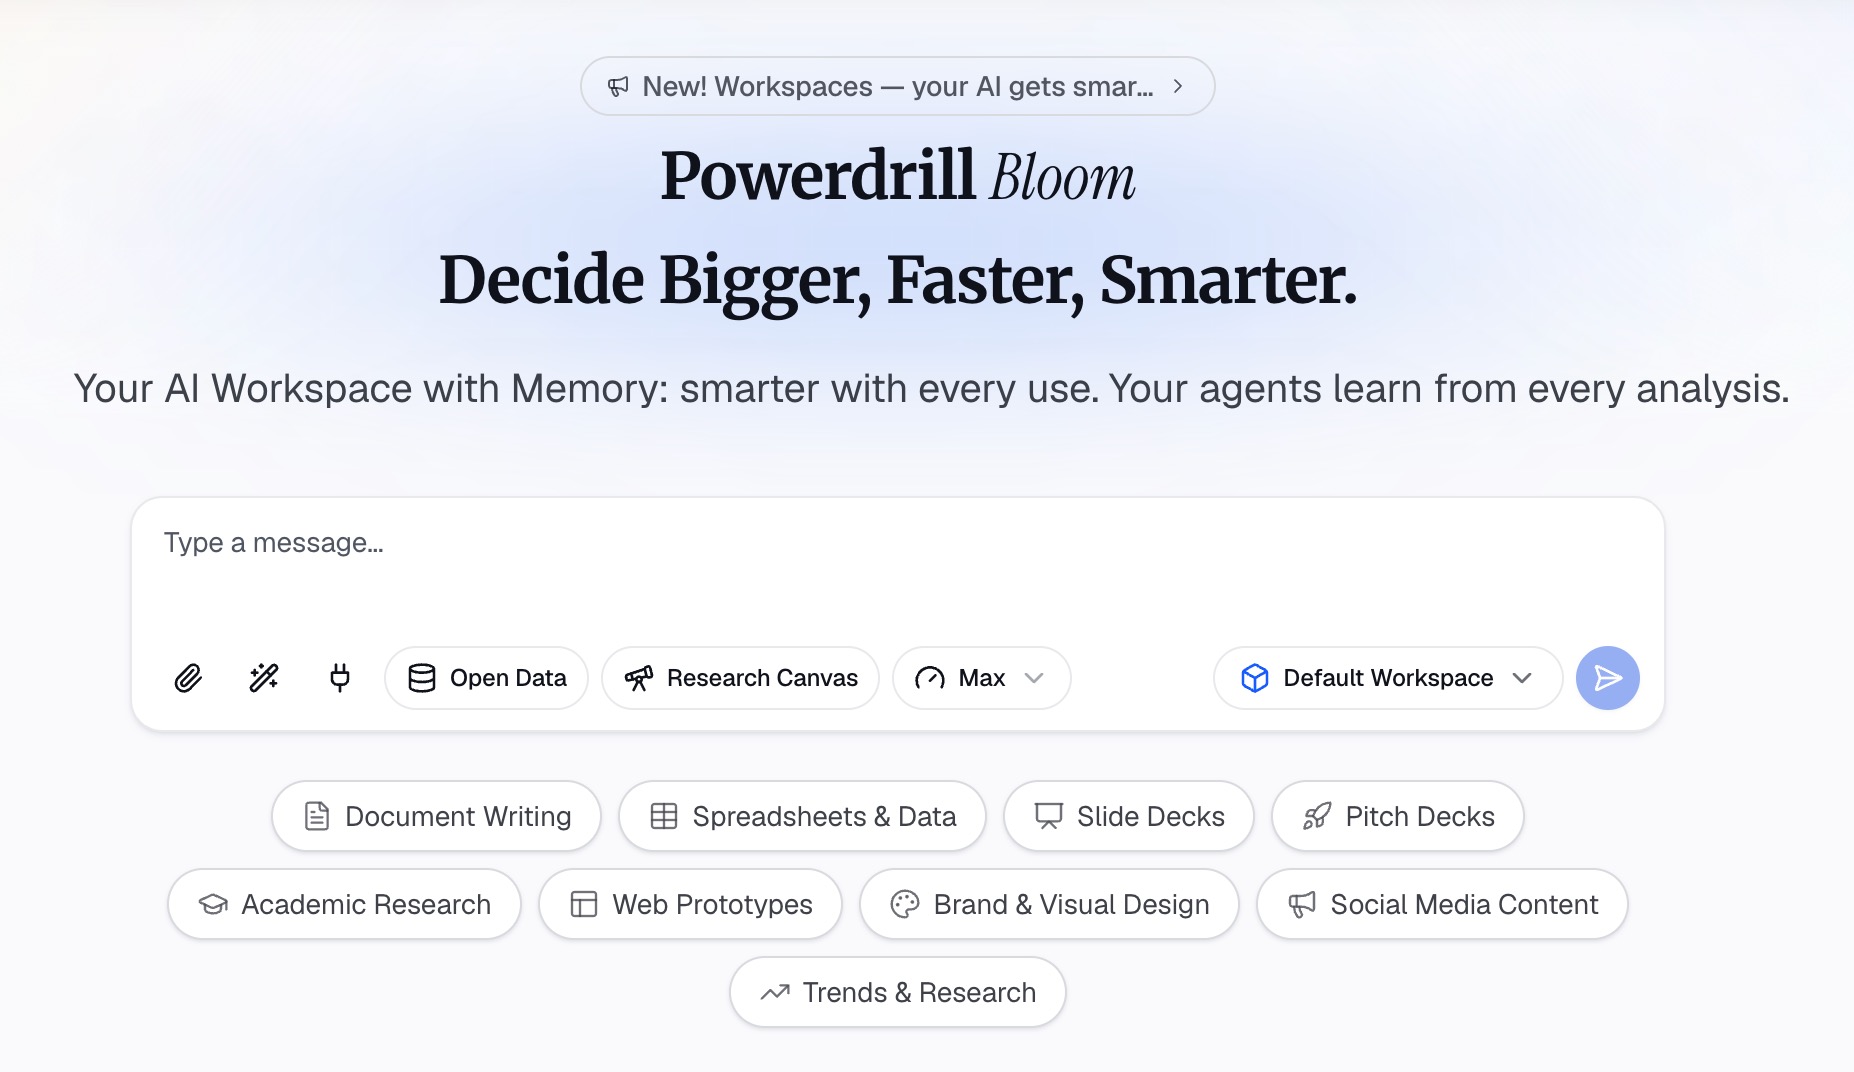
Open Powerdrill Bloom en upload de PDF's als een set. Beschrijf de matrix die je wilt in natuurlijke taal en noem de kolommen expliciet.
Handige standaardkolommen zijn auteur en jaar, onderzoeksvraag, methode, steekproef en context, belangrijkste bevindingen, en vermelde beperkingen. Voeg een of twee kolommen toe die specifiek zijn voor jouw vraag — de variabele waar het jou om gaat, of het theoretische kader dat elk artikel gebruikt.
Het zelf definiëren van de kolommen is het deel dat er echt toe doet. Ze bepalen waar het debat volgens jou over gaat, en een generieke set levert een generiek literatuuronderzoek op.
Stap 2: Verifieer elke rij aan de hand van de bron
Behandel de gegenereerde matrix als een concept met een bekende foutmodus. Extractie is betrouwbaar bij expliciete uitspraken en minder betrouwbaar bij alles wat geïmpliceerd is.
Controleer steekproefgroottes, data en effectrichtingen aan de hand van de artikelen zelf. Een omgedraaid teken of een verkeerd gelezen steekproefgrootte werkt door in je synthese en is later heel moeilijk te ontdekken.
Besteed bijzondere aandacht aan de kolom met beperkingen. Auteurs vermelden beperkingen op verschillende plaatsen — soms in de discussie, soms in een voetnoot — en dit is waar extractie het vaakst iets mist.
Stap 3: Lees de kolommen verticaal en benoem de tegenstrijdigheden
Gebruik de matrix nu waarvoor deze bedoeld is. Neem één kolom tegelijk en vraag wat het vakgebied collectief zegt.
Vraag de werkruimte om bronnen te groeperen op basis van hun standpunt over elk thema, en om aan te geven waar bevindingen met elkaar in strijd zijn. Tegenstrijdigheid is hier de meest waardevolle output — over overeenstemming is makkelijk te schrijven, maar bij tegenstrijdigheid bewijst een literatuuronderzoek pas echt zijn waarde.
Onderzoek de tegenstrijdigheden vervolgens zelf. Verschillen twee onderzoeken van mening vanwege de methode, de steekproef, de periode of de definitie? Die vraag is de intellectuele kern van het literatuuronderzoek, en het is aan jou om die te beantwoorden.
Werk je met een groot corpus aan PDF's? Probeer Powerdrill Bloom.
De matrix omzetten in lopende tekst
De matrix is de steiger, niet het literatuuronderzoek zelf. Het omzetten van de een in de ander volgt een betrouwbaar patroon.
Structureer op thema, nooit per artikel. Elke sectie behandelt één vraag en rapporteert wat de verzameling werk erover zegt, waarbij meerdere bronnen per bewering worden geciteerd.
Begin elke alinea met de bewering in plaats van het citaat. "Drie onderzoeken vonden geen verschil in productiviteit" leest als een betoog. "Smith (2023) vond..." leest als een opsomming.
Ga expliciet om met tegenstrijdigheden. Als onderzoeken het niet met elkaar eens zijn, zeg dat dan en leg de waarschijnlijke reden uit. Een literatuuronderzoek dat tegenstrijdigheden gladstrijkt, is minder nuttig dan een onderzoek dat ze in kaart brengt.
Sluit af met de leemte. Wat is er nog niet onderzocht, en waarom is dat belangrijk? Dit is wat een literatuuronderzoek het citeren waard maakt, en het komt rechtstreeks voort uit de lege cellen in je matrix.
| Matrix-element | Wat het wordt in lopende tekst |
|---|---|
| Een kolom | Een thematische sectie |
| Overeenstemming in een kolom | Een bewering met meerdere citaten |
| Tegenstrijdigheid in een kolom | Een alinea die uitlegt waarom bronnen verschillen |
| Een leeg gebied | De kennislacune in je conclusie |
| De kolom met beperkingen | Jouw beoordeling van de kwaliteit van het bewijs |
Voor de stap van het lezen zelf is er een stappenplan voor het automatisch samenvatten van een lang PDF-rapport in belangrijke inzichten. Om direct met de documenten te werken, is er een gids om te chatten met PDF.
Een dossier bijhouden dat je kunt verdedigen
Twee documenten zijn net zo belangrijk als het literatuuronderzoek zelf, and beide zijn makkelijker gaandeweg bij te houden dan achteraf te reconstrueren.
Het eerste is het zoekdossier. Geraadpleegde databases, exacte zoekreeksen, datumbereiken en het aantal resultaten in elke screeningsfase. Dit is waarmee een lezer de dekking kan beoordelen, en het is het deel dat beoordelaars als eerste bekijken wanneer een conclusie verrassend lijkt.
Het tweede is een notitie van waar een tool is gebruikt. Bij welke stappen een AI-werkruimte is gebruikt en wat je hebt gedaan om de output van elke stap te verifiëren. Veel instellingen vragen hier inmiddels rechtstreeks naar, en door dit opgeschreven te hebben, verandert een lastige vraag in een antwoord van twee regels.
Geen van beide documenten hoeft uitgebreid te zijn. Eén pagina is voor de meeste projecten voldoende voor beide, en een gedeeld document werkt beter dan een persoonlijk document.
Er is ook een praktisch voordeel dat verder gaat dan naleving. Zes weken na de extractie herinner je je echt niet meer of een specifieke steekproefgrootte uit de samenvatting of de methodensectie kwam. Het dossier beantwoordt dat zonder dat je veertig PDF's opnieuw hoeft te openen.
| Houd aantekeningen bij van | Waarom je het nodig zult hebben |
|---|---|
| Databases en zoekreeksen | De methodensectie, en eventuele vragen over de dekking |
| Aantallen in elke screeningsfase | Het reconstrueren van het selectieproces |
| In- en uitsluitingscriteria | Uitleggen waarom een bekend artikel ontbreekt |
| Welke stappen een tool hebben gebruikt | Openbaarmakingsvereisten |
| Wat je hebt geverifieerd, en hoe | Het beantwoorden van vragen over een specifiek getal |
Wanneer deze workflow niet de juiste keuze is
Het is de moeite waard om de gevallen te benoemen waarin de bovenstaande aanpak juist extra werk oplevert in plaats van bespaart.
Een literatuuronderzoek van vijf of zes artikelen heeft geen matrix nodig. Je kunt zes artikelen in je hoofd houden, en het bouwen van een steiger hiervoor kost meer dan het oplevert.
Een literatuuronderzoek waarin het betoog echt over één theoretische traditie gaat, in plaats van over verzamelde bevindingen, heeft minder baat bij tabellering. Extractie werkt goed bij meetbare beweringen en minder goed bij interpretatieve standpunten.
Een meta-analyse heeft strengere eisen dan alles wat hier wordt beschreven. Effectgroottes, heterogeniteit en de beoordeling van het risico op bias volgen allemaal vastgestelde protocollen, en de extractiestap moet aan die protocollen voldoen in plaats van aan een algemene set kolommen.
En als je vakgebied een geregistreerd protocol vereist, registreer dit dan voordat de extractie begint. Dit achteraf doen ondermijnt het doel.
Veelgemaakte fouten
Artikel voor artikel samenvatten. De meest voorkomende structurele fout. Het levert een geannoteerde bibliografie op met de verkeerde titel erboven.
De tool de thema's laten bepalen. Generieke kolommen leveren generieke secties op. De kolommen zijn je betoog in schetsvorm.
Verificatie overslaan omdat de output er zelfverzekerd uitziet. Vloeiende extractie en correcte extractie zijn verschillende eigenschappen, en het verschil wordt zichtbaar in je methodensectie.
Het niet vastleggen van de zoekopdracht. De artikelen die je niet hebt opgenomen, maken deel uit van de methode, en het achteraf reconstrueren van de zoekopdracht levert zelden dezelfde lijst op.
Citaten accepteren zonder ze te controleren. Elke verwijzing moet teruggaan naar de bron. Dit is niet-onderhandelbaar en kost minder tijd dan de gevolgen van een fout.
Tegenstrijdigheid behandelen als ruis. Tegenstrijdige bevindingen zijn het meest informatieve deel van de meeste literatuur.
De inleiding als eerste schrijven. De inkadering van een literatuuronderzoek moet volgen uit wat de matrix laat zien, niet eraan voorafgaan. Een inleiding die vóór het lezen is geschreven, neigt ertoe een conclusie aan te kondigen die niet door het bewijs wordt ondersteund.
Te veel verzamelen. Veertig goed gekozen artikelen zijn beter dan honderd die via een brede zoekopdracht zijn verzameld. Elke extra bron kost verificatietijd, en de marginale bronnen veranderen het betoog zelden.
De sectie over de kennislacune tot het laatst bewaren en afraffelen. De lacune is meestal het meest geciteerde deel van een literatuuronderzoek, en verdient meer dan een alinea die om middernacht is geschreven.
Snel naslagwerk
| Fase | Output | Tijd bespaard door AI |
|---|---|---|
| De vraag definiëren | Een afgebakende, beantwoordbare vraag | Geen — dit is aan jou |
| Zoeken en screenen | Een map met PDF's plus een zoekdossier | Geen — databases worden rechtstreeks doorzocht |
| Extraheren | Een ingevulde synthesematrix | Aanzienlijk |
| Verifiëren | Een gecontroleerde matrix | Geen — dit is de wisselwerking met de vorige rij |
| Synthetiseren | Gegroepeerde standpunten en benoemde tegenstrijdigheden | Aanzienlijk |
| Schrijven | Het literatuuronderzoek zelf | Matig, als eerste concept |
| Citeren | Geverifieerde verwijzingen | Geen |
Het patroon is zichtbaar in die laatste kolom. De hulp concentreert zich in het midden, waar volume het probleem is. Het begin en het einde blijven handmatig, omdat daar het oordeelsvermogen ligt.
Voor tools die specifiek op dit domein zijn gericht, zijn er overzichten van academische AI-tools en AI-tools voor de extractie en analyse van PDF-gegevens.
Veelgestelde vragen
Kan AI een literatuuronderzoek voor mij schrijven?
Het kan secties ontwerpen zodra je het materiaal hebt verzameld en geverifieerd, en het is echt sterk in extractie en vergelijking over veel artikelen heen. Drie dingen blijven jouw verantwoordelijkheid: het bepalen van de onderzoeksvraag, het garanderen van de dekking, en het nemen van verantwoordelijkheid voor de nauwkeurigheid. Een beoordelaar zal je op alle drie afrekenen.
Wat is een synthesematrix?
Een tabel waarin rijen bronnen zijn en kolommen thema's of variabelen. Als je een rij horizontaal leest, vat je één artikel samen; als je een kolom verticaal leest, zie je wat het vakgebied over één vraag zegt. Het is de standaard tussenstap tussen lezen en schrijven.
Is het gebruik van AI voor een literatuuronderzoek toegestaan?
Het beleid verschilt per instelling en tijdschrift, en veel vereisen inmiddels openbaarmaking van hoe AI is gebruikt. Controleer de richtlijnen die voor jou gelden en houd bij welke stappen een tool hebben gebruikt. De verantwoordelijkheid voor de nauwkeurigheid blijft in ieder geval bij de auteur liggen.
Wat vereist PRISMA?
PRISMA is een rapportagerichtlijn voor systematische reviews. Het vraagt auteurs om volledig te rapporteren waarom de review is uitgevoerd, welke methoden zijn gebruikt en welke resultaten zijn gevonden. Extensies dekken andere typen reviews, zoals scoping reviews.
Hoeveel bronnen moet een literatuuronderzoek bevatten?
Er is geen vast aantal, en het hangt af van de reikwijdte en het vakgebied. Wat belangrijker is, is dat je zoek- en screeningsproces is vastgelegd en verdedigbaar is. Een lezer moet kunnen zien wat er is opgenomen en wat er is weggelaten.
Bronnen: PRISMA-verklaring, prisma-statement.org, inclusief PRISMA 2020 en de bijbehorende extensies.