如何利用 AI 製作散佈圖:逐步指南
散佈圖顯示了兩個數值變數之間的關係,每個軸各代表一個變數,並用一個點表示每一次的觀測值。若要使用 AI 製作散佈圖,請上傳包含兩個數值欄位的檔案,並為每個軸的變數命名。接著要求生成包含趨勢線和相關性的圖表,然後解讀其模式並檢查離群值。
本指南將說明散佈圖所顯示的內容,以及何時該使用散佈圖而非折線圖。內容涵蓋在 Excel 和 Google Sheets 中的手動製作步驟、三步驟 AI 製作方法、如何解讀結果,以及一個實際操作範例。
散佈圖顯示的內容
NIST/SEMATECH 電子統計方法手冊給出了標準定義。散佈圖「揭示了兩個變數之間的關係或關聯」。這些關係「透過圖表中任何非隨機的結構呈現出來」。
其版面配置非常簡單。該手冊將其描述為「Y 值相對於對應 X 值的圖表」。垂直軸代表反應變數,水平軸則代表您認為可能與其相關的變數。
NIST 列出了散佈圖可以回答的五個問題:
- 這兩個變數是否相關?
- 它們是否呈線性關係?
- 它們是否呈非線性關係?
- Y 的變異程度是否會隨著 X 而改變?
- 是否存在離群值?
該手冊還解釋了為什麼此圖表在分析中如此重要。它稱其為「用於揭示變數之間關係之存在與本質的最重要且最常使用的圖形工具」。
何時該使用散佈圖而非折線圖
散佈圖和折線圖看起來可能很相似,特別是當點與點之間有線條相連時。兩者的差別在於水平軸。
Microsoft 的 Excel 文件對此有明確的解釋:「散佈圖一律有兩個數值軸。」而折線圖只有一個數值軸,其水平軸顯示的是等間距的類別。
這引出了一個簡單的規則。Microsoft 建議「如果您的資料包含非數值的 X 值,請使用折線圖」。對於數值的 X 值,它補充道:「通常最好使用散佈圖。」
| 適合使用散佈圖的情況 | 適合使用折線圖的情況 |
|---|---|
| 兩個變數皆為數字,例如價格與銷售數量 | 水平軸為時間或類別 |
| 您想觀察兩個測量值是否同步變動 | 您想顯示等間距時間內的趨勢 |
| 點可以落在水平軸上的任何位置 | 點按週期等間距排列 |
| 您計劃加入趨勢線或相關性 | 您計劃比較隨時間變化的多個數列 |
一個簡單的測試方法:如果您可以將水平軸的值從小到大排序,且排序後仍有實際意義,那麼就適合使用散佈圖。
開始之前的準備工作
乾淨的圖表始於乾淨的欄位。請先檢查以下四件事。
兩個數值欄位。一個用於 X 變數,另一個用於 Y 變數。請移除輸入在儲存格中的單位(例如「12 km」),因為它們會將數字變成文字。
每次觀測佔用一列。每一列應描述一個客戶、一筆訂單、一天或一次測試。同一欄中的總計和副總計會使圖表失真。
足夠的數據點。少數幾個點很難呈現出真實的模式。目標是至少有 20 個觀測值,如果資料雜訊較多,則需要更多。
明確的問題。在繪製圖表之前,先決定您預期會發現什麼。「外送時間是否隨距離增加而增加?」是一個比「顯示資料給我看」更好的起點。
如何在 Excel 或 Google Sheets 中製作散佈圖
手動製作非常適合單一圖表。這些方法不需要任何增益集。
選項 1:Excel
將 X 值放在左側欄,Y 值放在右側欄,並在第 1 列加上標題。選取這兩個欄位(包含標題)。
在「插入」索引標籤上,開啟「插入散佈圖 (X, Y) 或泡泡圖」選單,然後選擇「散佈圖」。Excel 會將每一列繪製為一個點。
若要加入趨勢線,請選取圖表,開啟「圖表項目」,然後勾選「趨勢線」。在「格式化趨勢線」中,您可以在圖表上顯示公式和 R-squared 值。至於相關係數本身,請在空白儲存格中輸入 =CORREL(A2:A31,B2:B31),並根據您的範圍進行調整。
選項 2:Google Sheets
選取這兩個欄位,選擇「插入」,然後選擇「圖表」。在圖表編輯器中,如果 Sheets 沒有自動選擇,請將圖表類型設定為「散佈圖」。
在「自訂」索引標籤上,開啟「系列」並勾選「趨勢線」。您也可以在那裡顯示 R-squared 值。=CORREL() 函數的使用方式與在 Excel 中相同。
手動製作在三個地方會變慢:資料通常需要先進行整理;離群值必須手動尋找並標記;而當您想測試多對變數時,您必須為每對變數重複每個步驟。
如何使用 AI 製作散佈圖
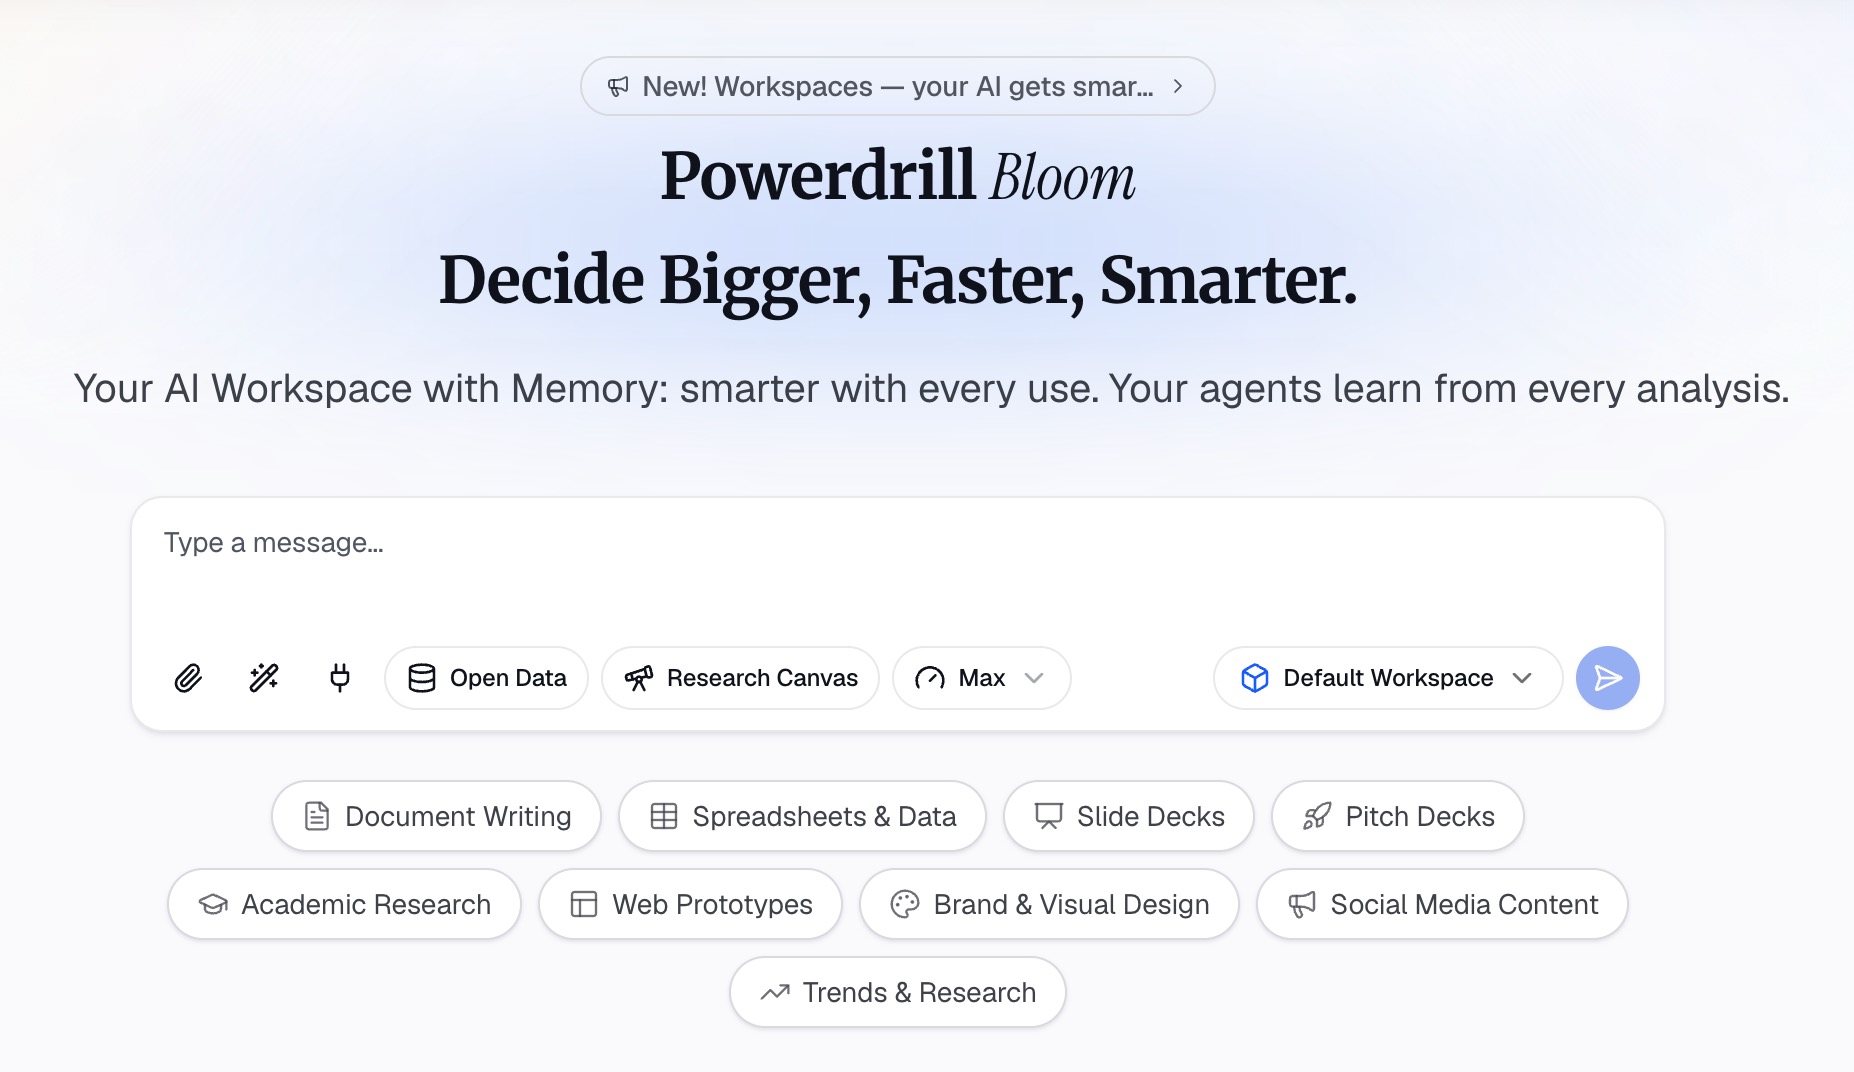
AI 工作區可以透過單一請求來整理欄位、建立圖表、加入趨勢線並標記離群值。以下三個步驟使用 Powerdrill Bloom。其 scatter graph creator 頁面描述了相同的流程:上傳資料集、在對話中描述圖表,然後下載結果。
步驟 1:上傳資料並為兩個變數命名
上傳包含您資料的試算表或 CSV。scatter graph creator 頁面指出它支援 CSV 和 Excel 等格式。
然後在您的請求中為這兩個變數命名。說明哪一個欄位放在水平軸,哪一個放在垂直軸。將您認為會影響另一個變數的變數放在水平軸上,這符合 NIST 的慣例。
If the file has many columns, add one sentence of context. "Each row is one delivery. I want to see whether time depends on distance." That helps the AI pick the right columns and ignore the rest.
步驟 2:要求生成散佈圖、趨勢線和相關性
在單一請求中要求生成圖表、線性趨勢線和相關係數。一個好的請求如下所示:「製作外送時間對距離的散佈圖。加入線性趨勢線,並顯示相關係數和 R-squared。」
同時要求提供資料整理的說明。AI 應該告訴您它因為缺失值或非數值而刪除了多少列。如果該數字令您驚訝,請修正來源檔案並重新執行。
如果您有多個候選變數,可以要求每對變數生成一個圖表,或者先生成一個相關性表。我們關於 correlation matrix 的指南涵蓋了更廣泛的第一步篩選。
步驟 3:解讀模式並標記離群值
在看數字之前,先觀察形狀。是否有明確的方向?關係是直線還是曲線?隨著 X 的增加,分佈是否變寬?
然後要求 AI 標記任何離群值及其詳細的列資料。遠離其他點的點通常是圖表中最有用的點。它可能是一個資料輸入錯誤,也可能是您的主管會問起的特殊情況。
在圖表下方用一句話做總結。說明方向、強度和任何注意事項。例如:「外送時間隨距離增加而增加,呈現強線性關係,但道路封閉期間的三筆延遲訂單除外。」scatter graph creator 頁面指出,您可以將圖表下載為高解析度的 PNG,以便用於簡報或報告。
如何解讀散佈圖
NIST 手冊透過範例圖表展示了常見的模式。以下是您最常遇到的模式。
| 模式 | 外觀特徵 | 代表的意義 |
|---|---|---|
| 無關係 | 無固定形狀的雲狀分佈 | 無法從 X 預測 Y |
| 強正相關 | 點緊密分佈在一條上升的線周圍 | 較大的 X 伴隨著較大的 Y |
| 強負相關 | 點緊密分佈在一條下降的線周圍 | 較大的 X 伴隨著較小的 Y |
| 曲線關係 | 點沿著彎曲的軌跡分佈 | 直線趨勢線會產生誤導 |
| 擴散分佈 | 隨著 X 增加,點的分佈呈扇形展開 | Y 的變異程度取決於 X |
| 離群值 | 一個遠離其他點的點 | 在得出結論之前先檢查該列資料 |
對於無關係的情況,NIST 描述為在給定的 X 下,Y 的值「到處分佈」。對於強正相關關係,它指出「一條直線可以很好地穿過資料」,且「線條周圍的散佈非常小」。
這種擴散模式有一個專業名稱。NIST 稱其為異質變異性(heteroscedasticity),意思是「Y 在 X 值上的變異不恆定」。這很重要,因為簡單的趨勢線會假設分佈大致均勻。
若要用數字來衡量直線關係的強度,請使用 correlation coefficient。接近 1 或 -1 的值表示強線性關係。接近 0 的值表示幾乎沒有線性關係,但可能仍然存在曲線關係。
相關性不等於因果關係
散佈圖顯示的是關聯性,而非因果關係。
NIST 手冊對此非常直接:「散佈圖揭示了關聯性,這是邁向因果關係的第一步。」它補充道,「儘管因果關係意味著關聯性,但關聯性並不意味著因果關係。」
在實務中,在聲稱因果關係之前,請先尋找第三個變數。冰淇淋銷量和曬傷人數在夏天都會上升,但兩者之間並沒有因果關係。當散佈圖顯示出強烈的模式時,請思考還有什麼會隨著 X 一起變化。
如果您需要對該關係進行建模,下一步是 regression analysis,它可以估算 X 每變動一個單位時 Y 的變動量。
實際操作範例
以下是一個使用虛擬數據的說明範例。一個外送團隊記錄了 30 筆訂單,距離單位為公里,外送時間單位為分鐘。
圖表顯示出明顯的上升趨勢。2 到 5 公里的短途行程需要 15 到 25 分鐘。20 到 25 公里的長途行程需要 55 到 70 分鐘。趨勢線穩定上升,相關係數為 0.91。
有三個點遠高於趨勢線。每筆都是 6 到 8 公里的訂單,但花費了超過 60 分鐘。標記這些點後發現,這三筆都發生在同一個下午的道路封閉期間。
標記了這三筆訂單後,結論就很簡單了:距離解釋了外送時間的大部分變異,且離群值有已知的原因。團隊可以根據距離規劃路線,並將道路封閉視為獨立的風險。
這是該圖表非常擅長的一種總結:一張圖表、一句話,以及一份簡短的例外清單。
保持客觀真實的變形與格式設定
當您有兩個以上的變數時,有兩種變形會有所幫助。NIST 手冊對這兩種都進行了描述。
散佈圖矩陣(scatterplot matrix)「在單一頁面上生成所有成對的散佈圖」。這是在選擇要研究哪些變數之前,快速瀏覽資料集中每一對變數的方法。
條件圖(conditioning plot,也稱為共繪圖或子集圖)顯示在第三個變數的不同值下,Y 相對於 X 的關係。它可以回答諸如「距離與時間的關係在工作日和週末是否相同」之類的問題。
格式設定也很重要。NIST 指出,最受歡迎的版本在每個數據點上使用標記,「且點與點之間沒有連接線」。點之間的線條可能會暗示資料具有某種實際上並不存在的順序。
還有三個習慣可以保持圖表的可讀性:
- 在兩個軸上都標記變數名稱和單位。
- 從合理的數值開始設定軸,如果不是從零開始,請特別說明。
- 數據點使用一種顏色,趨勢線則使用對比色。
常見錯誤
以下是最常導致圖表產生誤導的錯誤:
- 對數值的 X 值使用折線圖。Microsoft 的指南明確指出,數值的 X 值通常屬於散佈圖。
- 顛倒軸向。將自變數(影響因素)放在水平軸,將因變數(結果)放在垂直軸。
- 強行將線性趨勢線套用於曲線。先觀察形狀,再選擇趨勢線。
- 未經檢查就刪除離群值。離群值可能是一個錯誤,也可能是圖表中最重要的一個點。
- 將相關性視為因果關係。強烈的模式只代表值得進一步研究,並不代表能直接得出結論。
- 繪製的點太少。在 8 個點中呈現的模式可能會在 80 個點時消失。
當您想測試單一檔案中的多對變數時,您可以嘗試 Powerdrill Bloom。它會為每個圖表建立趨勢線並標記離群值。
常見問題
散佈圖是用來做什麼的?
散佈圖用於觀察兩個數值變數是否相關。每個點代表一次觀測,每個軸各有一個數值。NIST 手冊指出,它可以回答變數是否相關、關係是否為線性、變異程度是否隨 X 改變,以及是否存在離群值。
如何在 Excel 中製作散佈圖?
將 X 值放在左側欄,Y 值放在右側欄,然後選取這兩個欄位。在「插入」索引標籤上,開啟「插入散佈圖 (X, Y) 或泡泡圖」選單,然後選擇「散佈圖」。從「圖表項目」中加入趨勢線,並使用 CORREL 函數計算相關係數。
散佈圖和折線圖有什麼不同?
散佈圖有兩個數值軸,因此點可以落在水平軸上的任何位置。折線圖則有一個類別軸,點與點之間等間距排列,適合時間序列。Microsoft 建議對數值的 X 值使用散佈圖,對非數值的 X 值使用折線圖。
如何解讀散佈圖?
觀察方向、形狀和分佈。點一起上升表示正相關關係,點下降表示負相關關係。無固定形狀的雲狀分佈表示無關係,而呈扇形展開的分佈則表示變異程度取決於 X。在得出結論之前,請先檢查任何離群值。
AI 可以從試算表製作散佈圖嗎?
可以。將試算表上傳到 AI 工作區,為這兩個欄位命名,然後要求生成包含趨勢線和相關性的散佈圖。Powerdrill Bloom 的 scatter graph creator 支援 CSV 和 Excel 檔案,並允許您將圖表下載為 PNG。
來源: NIST/SEMATECH e-Handbook, Scatter Plot · NIST, Strong Linear Relationship · NIST, No Relationship · NIST, Heteroscedastic Variability · Microsoft Support, Present your data in a scatter chart or a line chart。指南閱讀日期為 2026 年 9 月 24 日。