วิธีเขียนการทบทวนวรรณกรรมด้วย AI: เวิร์กโฟลว์ปี 2026
การอ่านเอกสารวิจัย 40 ฉบับไม่ใช่เรื่องยาก แต่การจดจำเนื้อหาของเอกสารทั้ง 40 ฉบับไว้ในหัวพร้อมกัน เพื่อให้สามารถบอกได้ว่าแวดวงวิชาการมีความเห็นพ้องต้องกันในเรื่องใดบ้างต่างหากที่เป็นเรื่องยาก
นี่คือภารกิจที่พื้นที่ทำงาน AI สามารถช่วยเหลือได้อย่างแท้จริง และยังเป็นภารกิจที่มีขอบเขตที่ชัดเจนเช่นกัน มาตรฐานที่ควบคุมการทบทวนวรรณกรรมนั้นเป็นเรื่องของระเบียบวิธีวิจัยและความสามารถในการสืบย้อนแหล่งที่มา ซึ่งไม่มีเครื่องมือใดสามารถทำสิ่งเหล่านี้แทนคุณได้
คู่มือนี้จะครอบคลุมถึงจุดที่เครื่องมือสามารถช่วยได้จริง จุดที่คุณยังคงต้องรับผิดชอบ และขั้นตอนการทำงานที่จะช่วยสร้างร่างงานเขียนที่น่าเชื่อถือและสามารถโต้แย้งปกป้องได้
จุดประสงค์ที่แท้จริงของการทบทวนวรรณกรรม
การทบทวนวรรณกรรมไม่ใช่แค่การนำบทสรุปมากองรวมกัน แต่เป็นการโต้แย้งและอภิปรายเกี่ยวกับองค์ความรู้ที่มีอยู่ ว่ามีสิ่งใดที่ได้รับการพิสูจน์แล้ว ข้อค้นพบขัดแย้งกันตรงไหน และมีประเด็นใดบ้างที่ยังไม่มีใครศึกษา
ผู้อ่านต้องการทราบ 3 สิ่งจากงานเขียนนี้ ได้แก่ แวดวงวิชาการศึกษาเรื่องอะไร ศึกษาอย่างไร และผลลัพธ์ที่ได้นั้นนำไปสู่ข้อสรุปอย่างไร
ทุกขั้นตอนด้านล่างนี้มีขึ้นเพื่อตอบคำถามเหล่านั้น การสรุปเอกสารวิจัยทีละฉบับตามลำดับไม่สามารถตอบคำถามเหล่านี้ได้เลย นั่นคือเหตุผลที่การทบทวนวรรณกรรมแบบไล่เรียงทีละฉบับทำให้อ่านดูเหมือนเป็นรายการรายการหนึ่งมากกว่าการอภิปรายโต้แย้งเชิงวิชาการ
สิ่งที่มาตรฐานการรายงานกำหนดไว้
มาตรฐานที่ใช้กันแพร่หลายที่สุดในเรื่องนี้เป็นสิ่งที่คุณควรศึกษาทำความเข้าใจก่อนที่จะเริ่มเขียน เพราะมันจะช่วยให้เห็นภาพชัดเจนว่างานทบทวนวรรณกรรมของคุณจะถูกประเมินจากอะไร
The PRISMA statement — รายการรายงานที่แนะนำสำหรับการทบทวนวรรณกรรมอย่างเป็นระบบและการวิเคราะห์อภิมาน — นิยามตัวเองว่าเป็น "แนวทางที่ออกแบบมาเพื่อปรับปรุงการรายงานผลการทบทวนวรรณกรรมอย่างเป็นระบบ"
โปรดสังเกตคำว่า การรายงาน บทสรุปของข้อกำหนดนี้ระบุขอบเขตไว้อย่างชัดเจนว่า PRISMA "ให้แนวทางและตัวอย่างแก่ผู้เขียนเกี่ยวกับวิธีการรายงานอย่างครบถ้วนว่าเหตุใดจึงต้องทำการทบทวนวรรณกรรมอย่างเป็นระบบ" และประโยคเดียวกันนี้ยังกล่าวต่อไปว่า "ใช้ระเบียบวิธีวิจัยใด และพบผลลัพธ์อย่างไร"
ประโยคนั้นคือขอบเขตทั้งหมดสำหรับการใช้ AI ในบริบทนี้ เครื่องมือสามารถช่วยให้คุณเข้าใจสิ่งที่เอกสารวิจัยระบุไว้ได้ แต่ระเบียบวิธีวิจัยของคุณจะสามารถรายงานได้ก็ต่อเมื่อผ่านการตัดสินใจและการบันทึกข้อมูลโดยตัวคุณเอง ซึ่งเป็นงานที่ผู้เขียนต้องรับผิดชอบโดยตรง
PRISMA 2020 คือแนวทางหลัก ซึ่ง "ได้รับการเสริมด้วยส่วนขยายต่าง ๆ ของ PRISMA" ซึ่งข้อกำหนดระบุว่า "ให้แนวทางสำหรับการรายงานการทบทวนวรรณกรรมอย่างเป็นระบบในประเภทหรือแง่มุมต่าง ๆ" ตัวอย่างเช่น การทบทวนวรรณกรรมแบบกำหนดขอบเขต ก็จะมีส่วนขยายเฉพาะของตนเอง
ไม่ใช่ว่าการทบทวนวรรณกรรมทุกชิ้นจะเป็นการทบทวนวรรณกรรมอย่างเป็นระบบ และงานมอบหมายในชั้นเรียนส่วนใหญ่ก็ไม่ใช่เช่นนั้น แต่ตรรกะในการรายงานสามารถนำไปประยุกต์ใช้กับการทบทวนวรรณกรรมใด ๆ ก็ได้ นั่นคือ บอกเหตุผล บอกวิธีการ และบอกสิ่งที่คุณค้นพบ
จุดที่ AI ช่วยได้และจุดที่ช่วยไม่ได้
การมีความชัดเจนในเรื่องนี้จะช่วยลดปัญหาในภายหลัง โดยเฉพาะอย่างยิ่งหากสถาบันของคุณกำหนดให้มีหนังสือชี้แจงการใช้งานควบคู่ไปกับการทบทวนวรรณกรรม
| งาน | ความช่วยเหลือที่คาดหวังได้จริง | ผู้ที่ยังคงต้องรับผิดชอบ |
|---|---|---|
| การค้นหาเอกสารวิจัย | จำกัด — พื้นที่ทำงานจะอ่านเฉพาะสิ่งที่คุณป้อนให้เท่านั้น | คุณเป็นผู้รวบรวมคลังข้อมูลเอกสารวิจัยเอง |
| การดึงข้อมูลระเบียบวิธีวิจัย กลุ่มตัวอย่าง และข้อค้นพบ | ดีมาก สามารถทำได้พร้อมกันหลายเอกสาร | คุณเป็นผู้ตรวจสอบความถูกต้องกับแหล่งที่มาต้นฉบับ |
| การสร้างตารางเปรียบเทียบ (Comparison matrix) | ดีมาก | คุณเป็นผู้กำหนดคอลัมน์เอง |
| การตรวจหาข้อขัดแย้งระหว่างการศึกษาต่าง ๆ | ดีมากในการค้นหาและแสดงให้เห็น แต่ไม่สามารถตัดสินชี้ขาดได้ | คุณเป็นผู้ตัดสินว่าข้อค้นพบใดมีน้ำหนักน่าเชื่อถือกว่า |
| การเขียนเนื้อหาการสังเคราะห์วรรณกรรม | มีประโยชน์ในการใช้เป็นร่างแรก | คุณเป็นผู้เขียนข้ออภิปรายโต้แย้งเอง |
| การอ้างอิงและข้อความอ้างอิง | ต้องตรวจสอบทีละรายการ | คุณ ทุกครั้ง |
แถวแรกคือสิ่งที่คนมักเข้าใจผิด พื้นที่ทำงาน AI จะทำงานจากเอกสารที่คุณอัปโหลดขึ้นไปเท่านั้น มันไม่ได้ค้นหาฐานข้อมูลที่ต้องสมัครสมาชิกแทนคุณ ซึ่งหมายความว่าความครอบคลุมของการทบทวนวรรณกรรมของคุณจะขึ้นอยู่กับสิ่งที่คุณรวบรวมมาทั้งหมด
นี่ไม่ใช่ข้อควรระวังเล็ก ๆ น้อย ๆ เลย เพราะความครอบคลุมของข้อมูลคือสิ่งแรกที่ผู้ประเมินจะตั้งคำถามกับการทบทวนวรรณกรรมทุกชิ้น และยังเป็นขั้นตอนเดียวในกระบวนการนี้ที่ต้องทำด้วยตัวเองอย่างชัดเจน
การรวบรวมคลังข้อมูลเอกสารวิจัยเป็นอันดับแรก
ควรทำขั้นตอนนี้ก่อนที่จะเปิดใช้งานเครื่องมือใด ๆ คลังข้อมูลเอกสารวิจัยจะเป็นตัวกำหนดทุกสิ่งในขั้นตอนต่อ ๆ ไปของการทบทวนวรรณกรรม
กำหนดคำถามวิจัยให้แคบพอที่จะสามารถตอบได้ "การทำงานทางไกลและผลิตภาพ" เป็นเพียงหัวข้อกว้าง ๆ แต่ "การวัดผลกระทบด้านผลิตภาพของการทำงานทางไกลแบบเต็มเวลาในกลุ่มงานที่ใช้ความรู้ตั้งแต่ปี 2020" คือคำถามวิจัยที่มีขอบเขตชัดเจน
ค้นหาจากฐานข้อมูลในสาขาวิชาของคุณโดยตรง บันทึกข้อมูลว่าใช้ฐานข้อมูลใด คำค้นหาใด และช่วงวันที่เท่าใด คุณจำเป็นต้องใช้ข้อมูลทั้งสามนี้ในส่วนระเบียบวิธีวิจัย และการมานั่งนึกย้อนหลังในภายหลังเป็นเรื่องที่ยุ่งยากและน่าปวดหัวมาก
กำหนดเกณฑ์การคัดเข้าและคัดออก และจดบันทึกจำนวนเอกสารในแต่ละขั้นตอนการคัดกรอง มีเอกสารที่ค้นพบกี่ฉบับ เหลืออยู่กี่ฉบับหลังการคัดกรอง และได้อ่านฉบับเต็มกี่ฉบับ นี่คือร่องรอยหลักฐานที่ PRISMA กำหนดให้คุณรายงานอย่างชัดเจน
จากนั้นให้ส่งออกไฟล์ PDF ทั้งหมดไปยังโฟลเดอร์เดียวกัน โฟลเดอร์นั้นคือข้อมูลนำเข้าของคุณ
ข้อควรจำในทางปฏิบัติเกี่ยวกับคุณภาพของไฟล์: ไฟล์ PDF ที่สแกนมาโดยไม่มีเลเยอร์ข้อความจะดึงข้อมูลได้ยาก และคลังข้อมูลที่มีทั้งไฟล์ที่ชัดเจนและไฟล์สแกนปะปนกันจะทำให้ผลลัพธ์ที่ได้ไม่สม่ำเสมอ ควรตรวจสอบไฟล์บางส่วนก่อนที่จะทึกทักเอาเองว่าทั้งชุดสามารถอ่านได้ และให้เปลี่ยนไฟล์สแกนเหล่านั้นเป็นเวอร์ชันที่เป็นทางการจากสำนักพิมพ์หากมี
การสร้างตารางสังเคราะห์วรรณกรรม (Synthesis matrix)
ตารางสังเคราะห์วรรณกรรมคือเครื่องมือกลางที่เปลี่ยนกองเอกสารวิจัยให้กลายเป็นการทบทวนวรรณกรรม โดยแถวแนวนอนคือแหล่งที่มา คอลัมน์แนวตั้งคือประเด็นหรือตัวแปร และช่องในตารางจะเก็บข้อมูลที่แต่ละแหล่งที่มากล่าวถึงในแต่ละประเด็น
การอ่านตามแนวนอนจะทำให้คุณเข้าใจเอกสารวิจัยทีละฉบับ ส่วนการอ่านตามแนวตั้งในคอลัมน์จะทำให้คุณเห็นมุมมองของแวดวงวิชาการต่อคำถามข้อใดข้อหนึ่ง ซึ่งนั่นคือสิ่งที่คุณกำลังเขียนถึงจริง ๆ
ตารางนี้ยังช่วยให้เห็น "ความว่างเปล่า" หรือจุดที่ขาดหายไปได้อย่างชัดเจน ซึ่งการเขียนบรรยายทั่วไปไม่สามารถทำได้ ช่องว่างในคอลัมน์จะบ่งบอกว่ามีกลุ่มเอกสารวิจัยที่ไม่เคยพูดถึงประเด็นนั้น ๆ เลย ซึ่งความว่างเปล่านี้มักจะเป็นข้อสังเกตที่มีคุณค่าที่สุดในการนำไปเผยแพร่ผลงาน และมันแทบจะมองไม่เห็นเลยหากคุณอ่านเอกสารเรียงตามลำดับไปเรื่อย ๆ
ควรสร้างตารางนี้ในรูปแบบสเปรดชีตมากกว่าเอกสารข้อความทั่วไป เพราะคุณจะต้องจัดเรียง กรองข้อมูล และจัดเรียงใหม่ซ้ำแล้วซ้ำเล่า ซึ่งสเปรดชีตจะรองรับการทำงานลักษณะนี้ได้ดีกว่าไฟล์ข้อความธรรมดามาก
ขั้นตอนที่ 1: อัปโหลดคลังข้อมูลและกำหนดคอลัมน์
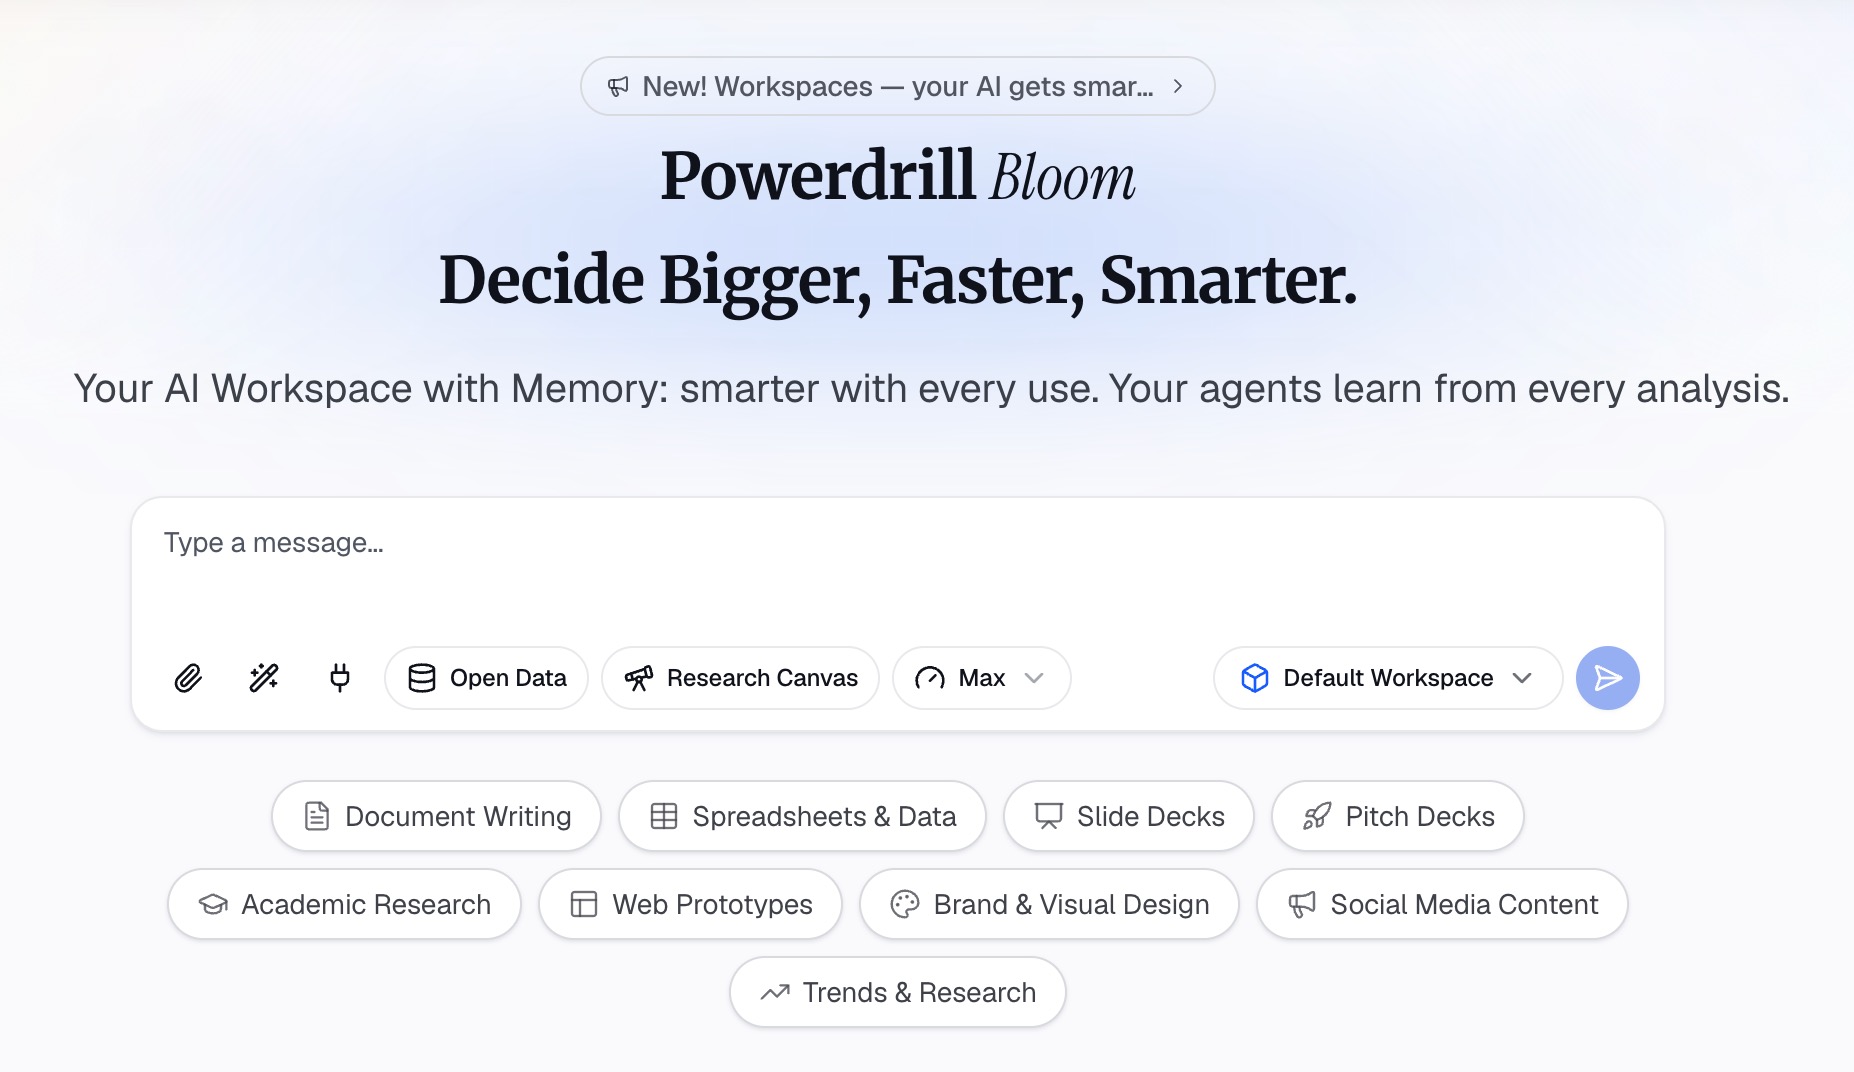
เปิด Powerdrill Bloom แล้วอัปโหลดไฟล์ PDF ทั้งชุดขึ้นไป อธิบายรูปแบบตารางที่คุณต้องการด้วยภาษาธรรมชาติ โดยระบุชื่อคอลัมน์ต่าง ๆ ให้ชัดเจน
คอลัมน์เริ่มต้นที่มีประโยชน์ ได้แก่ ผู้เขียนและปีที่เผยแพร่, คำถามวิจัย, ระเบียบวิธีวิจัย, กลุ่มตัวอย่างและบริบท, ข้อค้นพบหลัก และข้อจำกัดที่ระบุไว้ จากนั้นให้เพิ่มคอลัมน์เฉพาะอีกหนึ่งหรือสองคอลัมน์ที่ตรงกับคำถามวิจัยของคุณ เช่น ตัวแปรที่คุณสนใจ หรือกรอบแนวคิดเชิงทฤษฎีที่เอกสารแต่ละฉบับใช้
การกำหนดคอลัมน์ด้วยตัวเองคือส่วนที่สำคัญที่สุด เพราะมันจะสะท้อนถึงมุมมองของคุณว่าการอภิปรายโต้แย้งนี้เป็นเรื่องเกี่ยวกับอะไร หากใช้คอลัมน์ทั่วไปที่ไม่มีความเฉพาะเจาะจง ผลงานทบทวนวรรณกรรมที่ได้ก็จะออกมาธรรมดาและไม่มีความโดดเด่น
ขั้นตอนที่ 2: ตรวจสอบความถูกต้องของแต่ละแถวกับแหล่งที่มาต้นฉบับ
ให้คิดเสมอว่าตารางที่สร้างขึ้นมานั้นเป็นเพียงร่างแรกที่มีโอกาสเกิดข้อผิดพลาดได้ การดึงข้อมูลจะมีความน่าเชื่อถือสูงเมื่อเป็นข้อความที่ระบุไว้อย่างชัดเจน แต่อาจมีความน่าเชื่อถือน้อยลงเมื่อเป็นข้อมูลที่ต้องอาศัยการตีความหรือการอนุมาน
ตรวจสอบขนาดกลุ่มตัวอย่าง วันที่ และทิศทางของผลกระทบกับตัวเอกสารวิจัยโดยตรง ความผิดพลาดเพียงเล็กน้อย เช่น ทิศทางของผลลัพธ์ที่สลับกัน หรือขนาดกลุ่มตัวอย่างที่อ่านผิดพลาด จะส่งผลกระทบต่อเนื่องไปยังการสังเคราะห์วรรณกรรมของคุณ และจะตรวจพบได้ยากมากในภายหลัง
ให้ความสำคัญเป็นพิเศษกับคอลัมน์ข้อจำกัด เนื่องจากผู้เขียนมักจะระบุข้อจำกัดไว้ในตำแหน่งที่แตกต่างกันออกไป บางครั้งอยู่ในส่วนการอภิปรายผล บางครั้งอยู่ในเชิงอรรถ และนี่คือจุดที่การดึงข้อมูลอัตโนมัติมักจะมองข้ามไปบ่อยที่สุด
ขั้นตอนที่ 3: อ่านข้อมูลตามแนวตั้งในคอลัมน์และระบุข้อขัดแย้ง
ตอนนี้ได้เวลาใช้ประโยชน์จากตารางนี้ตามวัตถุประสงค์แล้ว ให้พิจารณาทีละคอลัมน์และตั้งคำถามว่าแวดวงวิชาการมีความเห็นร่วมกันอย่างไรในประเด็นนั้น ๆ
สั่งให้พื้นที่ทำงานจัดกลุ่มแหล่งที่มาตามจุดยืนในแต่ละประเด็น และระบุจุดที่ข้อค้นพบมีความขัดแย้งกัน ข้อขัดแย้งคือผลลัพธ์ที่มีค่าที่สุดในขั้นตอนนี้ เพราะความเห็นพ้องต้องกันนั้นเขียนถึงได้ง่าย แต่ความเห็นที่ขัดแย้งกันต่างหากคือจุดที่ทำให้งานทบทวนวรรณกรรมของคุณมีคุณค่าและน่าสนใจ
จากนั้นให้วิเคราะห์ข้อขัดแย้งเหล่านั้นด้วยตัวคุณเอง การศึกษาทั้งสองชิ้นมีความเห็นไม่ตรงกันเนื่องจากระเบียบวิธีวิจัย กลุ่มตัวอย่าง ช่วงเวลา หรือคำนิยามที่แตกต่างกันใช่หรือไม่? คำถามนี้คือหัวใจสำคัญทางปัญญาของการทบทวนวรรณกรรม และเป็นหน้าที่ของคุณที่จะต้องหาคำตอบ
กำลังทำงานกับคลังข้อมูล PDF ขนาดใหญ่อยู่ใช่ไหม? ลองใช้ Powerdrill Bloom เลย
การเปลี่ยนตารางให้เป็นเนื้อหาบรรยาย
ตารางเป็นเพียงโครงร่างชั่วคราว ไม่ใช่ตัวงานทบทวนวรรณกรรมที่เสร็จสมบูรณ์ การแปลงตารางให้เป็นเนื้อหาบรรยายนั้นมีรูปแบบขั้นตอนที่ชัดเจนและเชื่อถือได้ดังนี้
จัดระเบียบเนื้อหาตามประเด็น ห้ามจัดตามรายแผ่นเอกสารวิจัยโดยเด็ดขาด ในแต่ละส่วนควรหยิบยกคำถามขึ้นมาหนึ่งข้อแล้วรายงานว่าองค์ความรู้ในภาพรวมกล่าวถึงเรื่องนั้นอย่างไร โดยอ้างอิงแหล่งที่มาหลาย ๆ แหล่งสำหรับแต่ละข้ออ้างสิทธิ์
เริ่มต้นแต่ละย่อหน้าด้วยข้ออ้างสิทธิ์แทนที่จะเป็นชื่อผู้อ้างอิง ตัวอย่างเช่น "การศึกษา 3 ชิ้นพบว่าไม่มีความแตกต่างด้านผลิตภาพ" จะอ่านดูเป็นการอภิปรายโต้แย้ง ในขณะที่ "Smith (2023) พบว่า..." จะอ่านดูเหมือนเป็นเพียงรายการรายการหนึ่ง
จัดการกับข้อขัดแย้งอย่างตรงไปตรงมา เมื่อผลการศึกษาขัดแย้งกัน ให้ระบุออกมาอย่างชัดเจนแล้วอธิบายถึงสาเหตุที่เป็นไปได้ การทบทวนวรรณกรรมที่พยายามกลบเกลื่อนข้อขัดแย้งจะมีประโยชน์น้อยกว่าการทบทวนวรรณกรรมที่แสดงให้เห็นแผนผังของข้อขัดแย้งเหล่านั้นอย่างชัดเจน
ปิดท้ายด้วยช่องว่างทางการวิจัย มีประเด็นใดบ้างที่ยังไม่ได้รับการศึกษา และทำไมประเด็นนั้นจึงมีความสำคัญ? สิ่งนี้คือสิ่งที่ทำให้การทบทวนวรรณกรรมของคุณมีคุณค่าแก่การนำไปอ้างอิง ซึ่งข้อมูลนี้จะได้มาจากช่องว่างที่ไม่มีข้อมูลในตารางของคุณโดยตรง
| ส่วนประกอบของตาราง | สิ่งที่จะกลายเป็นในเนื้อหาบรรยาย |
|---|---|
| คอลัมน์ | หัวข้อย่อยตามประเด็น |
| ความเห็นพ้องต้องกันในคอลัมน์ | ข้ออ้างสิทธิ์ที่มีการอ้างอิงแหล่งที่มาหลายแหล่ง |
| ข้อขัดแย้งในคอลัมน์ | ย่อหน้าที่อธิบายว่าทำไมแหล่งข้อมูลจึงมีความแตกต่างกัน |
| ช่องว่างที่ไม่มีข้อมูล | ช่องว่างทางการวิจัยในส่วนสรุปของคุณ |
| คอลัมน์ข้อจำกัด | การประเมินคุณภาพของหลักฐานโดยตัวคุณเอง |
สำหรับขั้นตอนการอ่านด้วยตัวเองนั้น มีบทความแนะนำเกี่ยวกับ การสรุปรายงาน PDF ความยาว 50 หน้าให้เป็นข้อมูลเชิงลึกที่สำคัญโดยอัตโนมัติ และสำหรับการทำงานกับเอกสารโดยตรง มีคู่มือสำหรับ การแชทกับ PDF
การบันทึกข้อมูลเพื่อใช้ยืนยันและปกป้องงานวิจัยของคุณ
เอกสารสองฉบับนี้มีความสำคัญไม่แพ้ตัวงานทบทวนวรรณกรรมเอง และการบันทึกข้อมูลเหล่านี้ไปพร้อม ๆ กับการทำงานจะง่ายกว่าการมาสร้างขึ้นใหม่ในภายหลังอย่างมาก
ฉบับแรกคือบันทึกการค้นหา ได้แก่ ฐานข้อมูลที่สืบค้น, คำค้นหาที่ใช้จริง, ช่วงวันที่ และจำนวนเอกสารในแต่ละขั้นตอนการคัดกรอง ข้อมูลนี้จะช่วยให้ผู้อ่านสามารถประเมินความครอบคลุมของข้อมูลได้ และเป็นส่วนแรกที่ผู้ประเมินจะตรวจสอบเมื่อพบว่าข้อสรุปของคุณดูน่าประหลาดใจ
ฉบับที่สองคือบันทึกการใช้งานเครื่องมือ ได้แก่ ขั้นตอนใดบ้างที่มีการใช้พื้นที่ทำงาน AI และคุณได้ทำอย่างไรเพื่อตรวจสอบความถูกต้องของผลลัพธ์ในแต่ละขั้นตอน ปัจจุบันสถาบันหลายแห่งเริ่มกำหนดให้ระบุข้อมูลนี้อย่างตรงไปตรงมา และการบันทึกข้อมูลนี้ไว้ล่วงหน้าจะช่วยเปลี่ยนคำถามที่ตอบยากให้กลายเป็นคำตอบสั้น ๆ เพียงสองบรรทัดได้
เอกสารทั้งสองฉบับไม่จำเป็นต้องมีรายละเอียดซับซ้อน สำหรับโครงการส่วนใหญ่แล้ว ข้อมูลทั้งหมดสามารถสรุปได้ในหน้าเดียว และการใช้เอกสารที่แชร์ร่วมกันจะทำงานได้ดีกว่าการเก็บไว้ดูคนเดียว
นอกจากเรื่องการปฏิบัติตามข้อกำหนดแล้ว ยังมีประโยชน์ในทางปฏิบัติอีกด้วย เพราะหลังจากดึงข้อมูลไปแล้ว 6 สัปดาห์ คุณอาจจำไม่ได้ว่าขนาดกลุ่มตัวอย่างของการศึกษาชิ้นใดชิ้นหนึ่งมาจากบทคัดย่อหรือส่วนระเบียบวิธีวิจัย บันทึกนี้จะช่วยตอบคำถามนั้นได้ทันทีโดยที่คุณไม่ต้องเปิดไฟล์ PDF ทั้ง 40 ฉบับขึ้นมาดูใหม่
| สิ่งที่ต้องบันทึกไว้ | เหตุผลที่คุณจำเป็นต้องใช้ |
|---|---|
| ฐานข้อมูลและคำค้นหา | ใช้ในส่วนระเบียบวิธีวิจัย และเพื่อตอบข้อโต้แย้งเกี่ยวกับความครอบคลุมของข้อมูล |
| จำนวนเอกสารในแต่ละขั้นตอนการคัดกรอง | เพื่อสร้างกระบวนการคัดเลือกเอกสารขึ้นมาใหม่ |
| เกณฑ์การคัดเข้าและคัดออก | เพื่ออธิบายว่าเหตุใดเอกสารวิจัยที่เป็นที่รู้จักบางฉบับจึงไม่ได้ถูกรวมเข้ามา |
| ขั้นตอนใดบ้างที่ใช้เครื่องมือช่วย | เพื่อปฏิบัติตามข้อกำหนดในการเปิดเผยข้อมูล |
| ตรวจสอบข้อมูลใดบ้าง และตรวจสอบอย่างไร | เพื่อตอบข้อโต้แย้งเกี่ยวกับตัวเลขเฉพาะเจาะจงต่าง ๆ |
กรณีที่ขั้นตอนการทำงานนี้อาจไม่เหมาะสม
ควรระบุถึงกรณีที่แนวทางข้างต้นอาจเป็นการเพิ่มภาระงานมากกว่าการช่วยทุ่นแรง
การทบทวนวรรณกรรมที่มีเอกสารเพียง 5 หรือ 6 ฉบับไม่จำเป็นต้องใช้ตารางเปรียบเทียบ เพราะคุณสามารถจดจำเนื้อหาของเอกสารเพียง 6 ฉบับไว้ในหัวได้ และการสร้างตารางขึ้นมาสำหรับเอกสารจำนวนเท่านี้จะเสียเวลามากกว่าช่วยประหยัดเวลา
การทบทวนวรรณกรรมที่เน้นการอภิปรายโต้แย้งเกี่ยวกับแนวคิดเชิงทฤษฎีใดทฤษฎีหนึ่งโดยเฉพาะ มากกว่าการรวบรวมข้อค้นพบต่าง ๆ จะได้รับประโยชน์จากการทำตารางน้อยกว่า เนื่องจากการดึงข้อมูลอัตโนมัติจะทำงานได้ดีกับข้ออ้างสิทธิ์ที่สามารถวัดผลได้ แต่จะทำงานได้ไม่ดีนักกับจุดยืนหรือมุมมองที่ต้องอาศัยการตีความ
การวิเคราะห์อภิมาน (meta-analysis) มีข้อกำหนดที่เข้มงวดกว่าสิ่งที่อธิบายไว้ในที่นี้มาก ทั้งขนาดของผลกระทบ, ความต่างพันธุ์ และการประเมินความเสี่ยงของการมีอคติ ล้วนต้องปฏิบัติตามระเบียบวิธีวิจัยที่กำหนดไว้เป็นมาตรฐาน และขั้นตอนการดึงข้อมูลจะต้องสอดคล้องกับระเบียบวิธีวิจัยเหล่านั้น แทนที่จะใช้ชุดคอลัมน์ทั่วไปสำหรับงานทั่วไป
และหากสาขาวิชาของคุณกำหนดให้ต้องลงทะเบียนระเบียบวิธีวิจัยล่วงหน้า โปรดลงทะเบียนให้เรียบร้อยก่อนที่จะเริ่มขั้นตอนการดึงข้อมูล การทำเช่นนั้นในภายหลังจะทำให้วัตถุประสงค์ของการลงทะเบียนเสียไป
ข้อผิดพลาดที่พบบ่อย
การสรุปเอกสารวิจัยทีละฉบับ: นี่คือความล้มเหลวเชิงโครงสร้างที่พบบ่อยที่สุด เพราะมันจะทำให้งานของคุณกลายเป็นเพียงบรรณานุกรมอธิบายวิเคราะห์ที่ตั้งชื่อหัวข้อผิดไปเท่านั้น
การปล่อยให้เครื่องมือเป็นผู้กำหนดประเด็น: คอลัมน์ทั่วไปจะสร้างหัวข้อย่อยที่ธรรมดาและไม่มีความเฉพาะเจาะจง คอลัมน์เหล่านั้นควรเป็นโครงร่างของข้ออภิปรายโต้แย้งของคุณเอง
การข้ามขั้นตอนการตรวจสอบความถูกต้องเพียงเพราะผลลัพธ์ที่ได้ดูน่าเชื่อถือ: การดึงข้อมูลที่ดูสละสลวยกับการดึงข้อมูลที่ถูกต้องนั้นเป็นคนละเรื่องกัน และความแตกต่างนี้จะแสดงให้เห็นอย่างชัดเจนในส่วนระเบียบวิธีวิจัยของคุณ
การไม่ได้บันทึกขั้นตอนการค้นหา: เอกสารวิจัยที่คุณไม่ได้นำมารวมไว้ก็ถือเป็นส่วนหนึ่งของระเบียบวิธีวิจัยเช่นกัน และการมาสร้างขั้นตอนการค้นหาขึ้นใหม่ในภายหลังมักจะไม่ทำให้ได้รายการเอกสารที่ตรงกับของเดิม
การยอมรับการอ้างอิงโดยไม่มีการตรวจสอบ: การอ้างอิงทุกรายการจะต้องสามารถสืบย้อนกลับไปยังแหล่งที่มาต้นฉบับได้ นี่เป็นเรื่องที่ยอมความไม่ได้ และการตรวจสอบจะใช้เวลาน้อยกว่าการมาตามแก้ไขผลกระทบที่เกิดจากความผิดพลาดในภายหลังอย่างแน่นอน
การมองว่าข้อขัดแย้งเป็นเพียงข้อมูลรบกวนที่ไม่มีประโยชน์: แท้จริงแล้ว ข้อค้นพบที่ขัดแย้งกันคือส่วนที่ให้ข้อมูลและมีคุณค่ามากที่สุดในวรรณกรรมส่วนใหญ่
การเขียนบทนำก่อนเป็นอันดับแรก: การกำหนดกรอบของการทบทวนวรรณกรรมควรเป็นผลลัพธ์ที่ได้มาจากข้อมูลในตาราง ไม่ใช่เขียนขึ้นมาก่อน บทนำที่เขียนขึ้นก่อนการอ่านเอกสารมักจะนำไปสู่การด่วนสรุปในสิ่งที่หลักฐานเชิงประจักษ์ไม่ได้สนับสนุน
การรวบรวมเอกสารมากเกินไป: เอกสารวิจัย 40 ฉบับที่ได้รับการคัดสรรมาอย่างดีย่อมดีกว่าเอกสาร 100 ฉบับที่ได้มาจากการค้นหาแบบกว้าง ๆ แหล่งข้อมูลที่เพิ่มขึ้นทุกแหล่งหมายถึงเวลาที่ต้องเสียไปในการตรวจสอบความถูกต้อง และเอกสารที่ไม่มีความสำคัญมากนักก็แทบจะไม่ช่วยเปลี่ยนทิศทางของข้ออภิปรายโต้แย้งของคุณเลย
การทิ้งส่วนช่องว่างทางการวิจัยไว้เขียนเป็นส่วนสุดท้ายและเร่งรีบเขียน: ส่วนช่องว่างทางการวิจัยมักจะเป็นส่วนที่ถูกนำไปอ้างอิงมากที่สุดในงานทบทวนวรรณกรรม และมันสมควรได้รับความใส่ใจมากกว่าการเขียนเพียงย่อหน้าเดียวอย่างเร่งรีบในตอนเที่ยงคืน
ข้อมูลอ้างอิงด่วน
| ขั้นตอน | ผลลัพธ์ที่ได้ | เวลาที่ประหยัดได้โดย AI |
|---|---|---|
| กำหนดคำถามวิจัย | คำถามวิจัยที่มีขอบเขตและสามารถตอบได้ | ไม่มี — ขั้นตอนนี้เป็นหน้าที่ของคุณ |
| ค้นหาและคัดกรอง | โฟลเดอร์ที่รวบรวมไฟล์ PDF พร้อมบันทึกการค้นหา | ไม่มี — ต้องค้นหาจากฐานข้อมูลโดยตรง |
| ดึงข้อมูล | ตารางสังเคราะห์วรรณกรรมที่มีข้อมูลครบถ้วน | ประหยัดได้มากอย่างมีนัยสำคัญ |
| ตรวจสอบความถูกต้อง | ตารางที่ผ่านการตรวจสอบแล้ว | ไม่มี — นี่คือสิ่งที่คุณต้องแลกกับความสะดวกในขั้นตอนก่อนหน้า |
| สังเคราะห์ข้อมูล | การจัดกลุ่มจุดยืนและระบุข้อขัดแย้งที่ชัดเจน | ประหยัดได้มากอย่างมีนัยสำคัญ |
| เขียนงาน | ตัวงานทบทวนวรรณกรรมที่เสร็จสมบูรณ์ | ปานกลาง (ช่วยในส่วนของร่างแรก) |
| อ้างอิงแหล่งที่มา | รายการอ้างอิงที่ผ่านการตรวจสอบความถูกต้องแล้ว | ไม่มี |
คุณจะเห็นรูปแบบที่ชัดเจนในคอลัมน์สุดท้าย ความช่วยเหลือจะกระจุกตัวอยู่ตรงกลาง ซึ่งเป็นจุดที่ปริมาณข้อมูลเป็นปัญหาหลัก ส่วนขั้นตอนเริ่มต้นและขั้นตอนสุดท้ายยังคงต้องทำด้วยตัวเอง เพราะเป็นขั้นตอนที่ต้องใช้การตัดสินใจและการวิเคราะห์ของมนุษย์
สำหรับเครื่องมือที่ออกแบบมาเพื่อการใช้งานในด้านนี้โดยเฉพาะ เราได้รวบรวม เครื่องมือ AI สำหรับงานวิชาการ และ เครื่องมือ AI สำหรับการดึงข้อมูลและการวิเคราะห์ไฟล์ PDF ไว้ให้คุณแล้ว
คำถามที่พบบ่อย
AI สามารถเขียนบททบทวนวรรณกรรมให้ฉันได้หรือไม่?
AI สามารถช่วยร่างเนื้อหาในแต่ละส่วนได้หลังจากที่คุณรวบรวมและตรวจสอบข้อมูลเรียบร้อยแล้ว และมันมีความสามารถที่โดดเด่นมากในการดึงข้อมูลและเปรียบเทียบเอกสารวิจัยหลาย ๆ ฉบับพร้อมกัน อย่างไรก็ตาม มี 3 สิ่งที่คุณยังคงต้องทำด้วยตัวเอง ได้แก่ การกำหนดคำถามวิจัย การรับประกันความครอบคลุมของข้อมูล และการรับผิดชอบต่อความถูกต้องของเนื้อหา ซึ่งผู้ประเมินจะพิจารณาสิ่งเหล่านี้จากตัวคุณโดยตรง
ตารางสังเคราะห์วรรณกรรม (Synthesis matrix) คืออะไร?
ตารางที่แถวแนวนอนคือแหล่งที่มา และคอลัมน์แนวตั้งคือประเด็นหรือตัวแปร การอ่านตามแนวนอนจะช่วยสรุปข้อมูลของเอกสารวิจัยทีละฉบับ ส่วนการอ่านตามแนวตั้งจะแสดงให้เห็นว่าแวดวงวิชาการกล่าวถึงคำถามข้อใดข้อหนึ่งอย่างไร นี่คือขั้นตอนกลางที่เป็นมาตรฐานระหว่างการอ่านและการเขียน
อนุญาตให้ใช้ AI ในการทบทวนวรรณกรรมหรือไม่?
นโยบายจะแตกต่างกันไปตามแต่ละสถาบันและวารสารวิชาการ ซึ่งในปัจจุบันหลายแห่งกำหนดให้ต้องเปิดเผยข้อมูลการใช้งาน AI โปรดตรวจสอบแนวทางปฏิบัติที่บังคับใช้กับคุณ และบันทึกข้อมูลไว้ว่าขั้นตอนใดบ้างที่มีการใช้เครื่องมือช่วย อย่างไรก็ตาม ความรับผิดชอบต่อความถูกต้องของข้อมูลทั้งหมดจะยังคงเป็นของผู้เขียนเสมอ
PRISMA กำหนดให้ต้องทำอะไรบ้าง?
PRISMA คือแนวทางการรายงานสำหรับการทบทวนวรรณกรรมอย่างเป็นระบบ โดยกำหนดให้ผู้เขียนรายงานอย่างครบถ้วนว่าเหตุใดจึงต้องทำการทบทวนวรรณกรรม ใช้ระเบียบวิธีวิจัยใด และพบผลลัพธ์อย่างไร นอกจากนี้ยังมีส่วนขยายที่ครอบคลุมการทบทวนวรรณกรรมประเภทอื่น ๆ เช่น การทบทวนวรรณกรรมแบบกำหนดขอบเขต
การทบทวนวรรณกรรมควรมีแหล่งข้อมูลจำนวนเท่าใด?
ไม่มีตัวเลขที่กำหนดไว้ตายตัว โดยจะขึ้นอยู่กับขอบเขตและสาขาวิชา สิ่งที่สำคัญกว่าคือกระบวนการค้นหาและคัดกรองข้อมูลของคุณจะต้องได้รับการบันทึกไว้และสามารถอธิบายเหตุผลได้อย่างน่าเชื่อถือ ผู้อ่านควรจะสามารถบอกได้ว่ามีข้อมูลใดบ้างที่ถูกรวมเข้ามาและข้อมูลใดบ้างที่ถูกคัดออกไป
แหล่งที่มา: PRISMA statement, prisma-statement.org รวมถึง PRISMA 2020 และส่วนขยายต่าง ๆ