AI를 활용한 문헌 고찰 작성법: 2026년 워크플로우
논문 40편을 읽는 것은 그리 어렵지 않습니다. 진짜 어려운 일은 해당 분야에서 실제로 합의된 내용이 무엇인지 파악할 수 있도록 40편의 논문을 한 번에 머릿속에 담아두는 것입니다.
그것이 바로 AI 워크스페이스가 진정으로 도움이 되는 작업입니다. 또한 이는 엄격한 경계가 있는 작업이기도 합니다. 문헌 고찰을 규율하는 기준은 방법론과 추적 가능성에 관한 것이며, 어떤 도구도 이를 대신 제공해 주지 않습니다.
이 가이드에서는 AI의 도움이 실질적으로 작용하는 부분과 여전히 본인의 책임으로 남는 부분, 그리고 신뢰할 수 있는 초안을 작성하는 워크플로우를 다룹니다.
문헌 고찰의 진짜 목적
문헌 고찰은 단순히 요약본을 쌓아놓은 것이 아닙니다. 이는 일련의 연구 결과물에 대한 논증입니다. 무엇이 규명되었는지, 연구 결과들이 어디에서 충돌하는지, 그리고 아직 아무도 조사하지 않은 것은 무엇인지 밝히는 것입니다.
독자는 문헌 고찰에서 세 가지를 원합니다. 해당 분야에서 무엇을 연구했는가, 어떻게 연구했는가, 그리고 그 결과가 시사하는 바는 무엇인가?
아래의 모든 단계는 이 질문 중 하나에 답하기 위해 존재합니다. 각 논문을 순서대로 요약하는 방식으로는 이 중 어떤 질문에도 답할 수 없습니다. 논문별로 나열하는 방식의 문헌 고찰이 논증이 아니라 단순한 목록처럼 읽히는 이유가 바로 여기에 있습니다.
보고 기준이 요구하는 사항
글을 쓰기 전에 이 분야에서 가장 널리 사용되는 기준을 읽어볼 가치가 있습니다. 문헌 고찰이 어떤 기준으로 평가받는지 명확히 알 수 있기 때문입니다.
The PRISMA statement — Preferred Reporting Items for Systematic reviews and Meta-Analyses — describes itself as "a guideline designed to improve the reporting of systematic reviews."
Note the word reporting. The statement's own summary is specific about its scope. PRISMA "provides authors with guidance and examples of how to completely report why a systematic review was done." The same sentence continues: "what methods were used, and what results were found."
이 문장은 여기서 AI를 사용하기 위한 전체적인 한계 조건을 보여줍니다. 도구는 논문이 무엇을 말하는지 파악하는 데 도움을 줄 수 있습니다. 하지만 보고할 수 있는 방법론은 여러분이 내리고 기록한 결정들을 통해 만들어지며, 이는 전적으로 저자의 몫입니다.
PRISMA 2020 is the main guideline. It is "complemented by various PRISMA extensions," which the statement says "provide guidance for the reporting of different types or aspects of systematic reviews." Scoping reviews, for instance, have their own extension.
모든 문헌 고찰이 체계적 문헌고찰인 것은 아니며, 대부분의 대학 과제도 마찬가지입니다. 하지만 보고의 논리는 모든 문헌 고찰에 적용됩니다. 왜 했는지, 어떻게 했는지, 그리고 무엇을 발견했는지 밝히는 것입니다.
AI가 도움이 되는 부분과 그렇지 않은 부분
이 부분을 명확히 해두면 나중에 번거로운 일을 피할 수 있습니다. 특히 소속 기관에서 문헌 고찰과 함께 AI 사용 공개 진술서를 요구하는 경우 더욱 그렇습니다.
| 작업 | 현실적인 도움 수준 | 책임의 주체 |
|---|---|---|
| 논문 찾기 | 제한적 — 워크스페이스는 사용자가 제공한 자료만 읽음 | 사용자 (코퍼스 수집) |
| 방법론, 표본, 연구 결과 추출 | 강력함, 여러 문서를 동시에 처리 | 사용자 (원문 대조 검증) |
| 비교 매트릭스 작성 | 강력함 | 사용자 (열 항목 결정) |
| 연구 간의 이견 발견 | 표면화에는 강력하나, 판정에는 취약함 | 사용자 (어떤 결과가 타당한지 판단) |
| 종합 서술 작성 | 초안 작성에 유용함 | 사용자 (논증 작성) |
| 인용 및 발췌 | 개별적으로 반드시 확인해야 함 | 사용자 (매번 직접 확인) |
첫 번째 행은 사람들이 가장 많이 오해하는 부분입니다. AI 워크스페이스는 사용자가 업로드한 문서를 바탕으로 작동합니다. 사용자를 대신해 유료 구독 데이터베이스를 검색해 주지 않으므로, 문헌 고찰의 범위는 전적으로 사용자가 수집한 자료에 의해 결정됩니다.
이는 결코 가벼운 경고가 아닙니다. 범위(Coverage)는 심사위원이 문헌 고찰에서 가장 먼저 의문을 제기하는 부분입니다. 또한 이 프로세스에서 명백히 수동으로 진행해야 하는 유일한 부분이기도 합니다.
먼저 코퍼스 수집하기
어떤 도구든 열기 전에 이 작업부터 하십시오. 코퍼스가 문헌 고찰의 후속 단계를 모두 결정합니다.
답을 찾을 수 있을 만큼 질문을 좁게 정의하십시오. "원격 근무와 생산성"은 광범위한 주제이지만, "2020년 이후 지식 노동 직무에서 완전 원격 근무가 미치는 생산성 영향 측정"은 명확한 경계가 있는 질문입니다.
해당 분야의 데이터베이스를 직접 검색하십시오. 어떤 데이터베이스를 썼는지, 어떤 검색어를 사용했는지, 검색 기간은 언제였는지 기록해 두십시오. 방법론 섹션에 이 세 가지가 모두 필요하며, 나중에 이를 다시 복원하려면 매우 고통스럽습니다.
선정 및 제외 기준을 적용하고, 각 단계에서의 논문 수를 기록하십시오. 검색된 문헌 수, 스크리닝 후 남은 수, 전체를 정독한 수 등을 기록해야 합니다. 이것이 바로 PRISMA가 보고하도록 요구하는 추적 경로입니다.
그런 다음 PDF 파일들을 하나의 폴더로 내보내십시오. 그 폴더가 바로 입력 데이터가 됩니다.
파일 품질에 관한 실질적인 팁이 있습니다. 텍스트 레이어가 없는 스캔된 PDF는 텍스트 추출이 잘 되지 않으며, 깨끗한 파일과 스캔된 파일이 섞인 코퍼스는 일관되지 않은 결과를 낳습니다. 전체 파일이 잘 읽힌다고 가정하기 전에 몇 개를 먼저 확인해 보고, 출판사 버전이 존재하는 경우 스캔본을 대체하십시오.
종합 매트릭스 구축하기
종합 매트릭스는 산더미 같은 논문을 문헌 고찰로 전환해 주는 중간 결과물입니다. 행은 출처(논문)이고, 열은 주제나 변수이며, 셀에는 각 출처가 각 주제에 대해 언급한 내용이 들어갑니다.
행을 가로로 읽으면 논문 한 편의 내용이 됩니다. 열을 세로로 읽으면 하나의 질문에 대한 해당 분야의 전반적인 입장을 파악할 수 있으며, 이것이 바로 여러분이 실제로 작성해야 하는 내용입니다.
또한 매트릭스는 일반 글에서는 보이지 않는 '공백'을 시각화해 줍니다. 열의 빈 영역은 해당 주제를 전혀 다루지 않은 논문 그룹을 나타냅니다. 이 공백은 종종 전체 연구에서 가장 학술지에 게재할 만한 가치가 있는 관찰 결과가 되며, 논문을 순서대로 읽을 때는 거의 발견하기 어렵습니다.
일반 문서가 아닌 스프레드시트로 작성하십시오. 정렬, 필터링, 재정렬을 반복하게 될 텐데, 텍스트 파일과 달리 표 형식은 이러한 작업을 수월하게 감당할 수 있습니다.
1단계: 코퍼스 업로드 및 열 정의하기
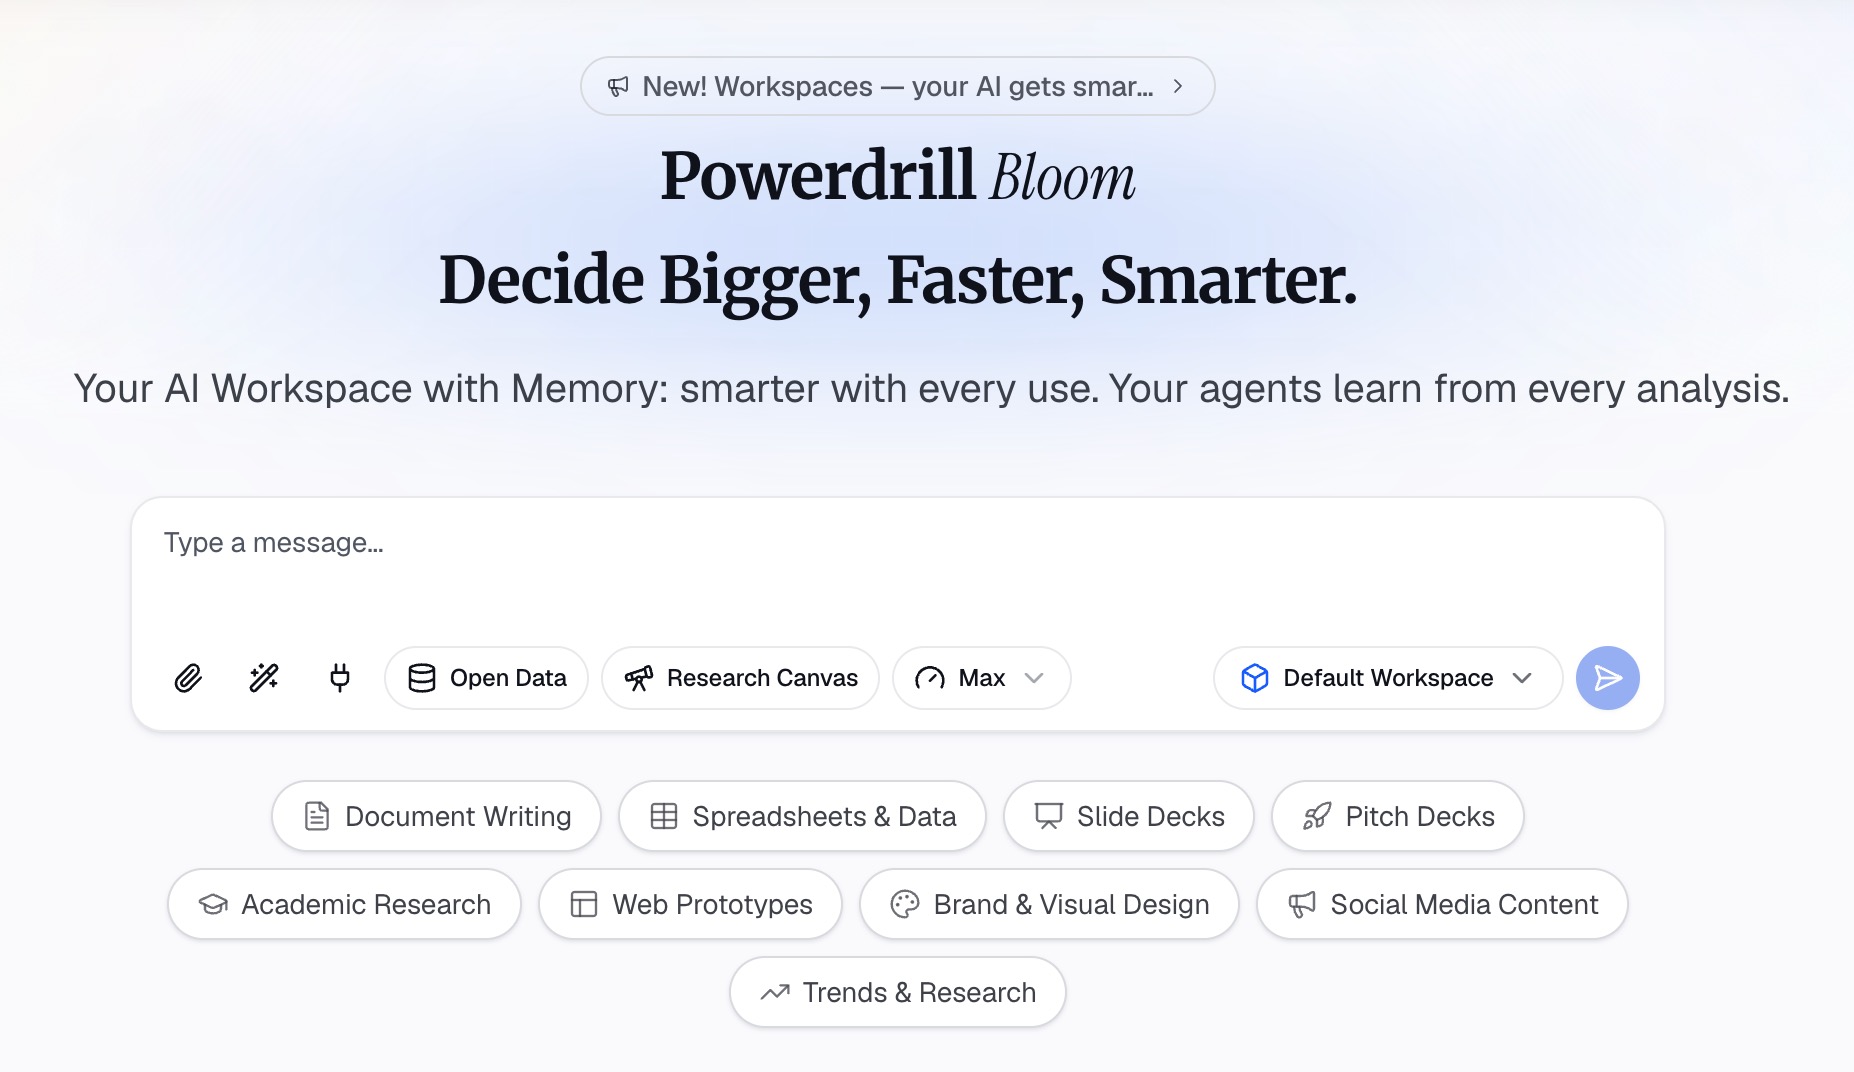
Powerdrill Bloom을 열고 PDF 파일들을 세트로 업로드합니다. 원하는 매트릭스를 자연어로 설명하고 열 이름을 명시적으로 지정합니다.
유용한 기본 열로는 저자 및 연도, 연구 질문, 방법론, 표본 및 맥락, 주요 결과, 언급된 한계점 등이 있습니다. 여기에 여러분의 질문에 특화된 열(관심 있는 변수나 각 논문이 사용한 이론적 프레임워크 등)을 한두 개 추가하십시오.
열을 직접 정의하는 것이 중요한 부분입니다. 열은 여러분이 생각하는 논쟁의 핵심이 무엇인지를 담아내며, 평범한 열 구성은 평범한 문헌 고찰을 낳을 뿐입니다.
2단계: 원문과 대조하여 각 행 검증하기
생성된 매트릭스는 오류 가능성이 있는 초안으로 취급하십시오. 텍스트 추출은 명시적인 진술에 대해서는 신뢰할 수 있지만, 암시적인 내용에 대해서는 신뢰도가 떨어집니다.
표본 크기, 날짜, 효과의 방향 등을 논문 원문과 대조하여 확인하십시오. 부호가 반대로 표기되거나 표본 크기를 잘못 읽은 오류가 종합 분석에 그대로 반영되면 나중에 잡아내기가 매우 어렵습니다.
한계점 열에 특히 주의를 기울이십시오. 저자들은 한계점을 고찰(discussion)이나 각주 등 다양한 곳에 기술하기 때문에, 이 부분에서 추출 오류가 가장 자주 발생합니다.
3단계: 열을 세로로 읽으며 이견 식별하기
이제 매트릭스를 본래 목적에 맞게 활용하십시오. 한 번에 한 열씩 살펴보며 해당 분야가 집단적으로 무엇을 말하고 있는지 자문해 보십시오.
워크스페이스에 각 주제에 대한 입장에 따라 출처를 그룹화하고, 연구 결과가 충돌하는 지점을 표시해 달라고 요청하십시오. 여기서 충돌(Conflict)은 가장 가치 있는 결과물입니다. 일치하는 의견은 쓰기 쉽지만, 이견이 존재하는 지점이야말로 문헌 고찰의 진정한 가치가 드러나는 곳이기 때문입니다.
그런 다음 그 충돌을 직접 면밀히 따져보십시오. 두 연구가 방법론, 표본, 기간, 혹은 정의의 차이 때문에 서로 다른 결과를 냈습니까? 이 질문이 바로 문헌 고찰의 지적 핵심이며, 여러분이 직접 답해야 할 몫입니다.
방대한 PDF 코퍼스를 다루고 계신가요? Powerdrill Bloom을 사용해 보세요.
매트릭스를 글로 변환하기
매트릭스는 뼈대일 뿐 문헌 고찰 본문이 아닙니다. 매트릭스를 글로 변환하는 데는 확실한 패턴이 있습니다.
절대 논문별이 아니라 주제별로 구성하십시오. 각 섹션은 하나의 질문을 다루고, 주장마다 여러 출처를 인용하면서 일련의 연구들이 이에 대해 무엇을 말하는지 보고해야 합니다.
각 문단은 인용구가 아닌 주장으로 시작하십시오. "세 건의 연구에서 생산성 차이가 없는 것으로 나타났다"는 논증처럼 읽힙니다. 반면 "Smith(2023)는 ...을 발견했다"는 단순한 목록처럼 읽힙니다.
의견 충돌을 명시적으로 다루십시오. 연구들이 서로 다를 때는 그렇다고 밝히고 그 원인으로 추정되는 이유를 설명하십시오. 이견을 뭉뚱그려 넘어가는 문헌 고찰은 이견의 지형을 명확히 보여주는 문헌 고찰보다 가치가 떨어집니다.
연구의 공백(gap)으로 마무리하십시오. 아직 조사되지 않은 것은 무엇이며, 그것이 왜 중요합니까? 이것이 바로 문헌 고찰을 인용할 가치가 있게 만드는 요소이며, 매트릭스의 빈 셀에서 바로 도출됩니다.
| 매트릭스 요소 | 글로 변환된 형태 |
|---|---|
| 하나의 열 | 주제별 섹션 |
| 열 세로 방향의 일치된 의견 | 여러 인용이 포함된 주장 |
| 열 세로 방향의 상충되는 의견 | 출처 간 차이가 발생하는 이유를 설명하는 문단 |
| 빈 영역 | 결론부의 연구 공백(gap) |
| 한계점 열 | 근거 품질에 대한 저자의 평가 |
읽기 단계 자체에 대해서는 긴 PDF 보고서를 핵심 인사이트로 자동 요약하는 방법에 대한 튜토리얼이 있습니다. 문서와 직접 상호작용하려면 PDF와 채팅하기 가이드를 참고하십시오.
방어 가능한 기록 유지하기
문헌 고찰 본문만큼 중요한 두 가지 문서가 있으며, 둘 다 나중에 복원하는 것보다 진행하면서 기록해 두르는 것이 훨씬 쉽습니다.
첫 번째는 검색 기록입니다. 쿼리한 데이터베이스, 정확한 검색어, 날짜 범위, 그리고 각 스크리닝 단계에서의 문헌 수입니다. 이는 독자가 조사 범위를 판단할 수 있게 해주는 기준이며, 결론이 의외일 때 심사위원이 가장 먼저 살펴보는 부분입니다.
두 번째는 도구가 개입된 부분에 대한 기록입니다. 어떤 단계에서 AI 워크스페이스를 사용했는지, 그리고 각 출력을 검증하기 위해 무엇을 했는지 적어두어야 합니다. 최근 많은 기관에서 이를 직접 요구하고 있으며, 이를 미리 작성해 두면 곤란할 수 있는 질문에 두 줄짜리 답변으로 명쾌하게 대응할 수 있습니다.
두 문서 모두 거창할 필요는 없습니다. 대부분의 프로젝트에서는 단 한 페이지로 두 가지를 모두 커버할 수 있으며, 개인 문서보다는 공유 문서로 관리하는 것이 더 효과적입니다.
규정 준수 외에도 실질적인 이점이 있습니다. 텍스트를 추출하고 6주일이 지나면 특정 표본 크기가 초록에서 나왔는지 방법론 섹션에서 나왔는지 기억나지 않을 것입니다. 이 기록이 있다면 PDF 40편을 다시 열지 않고도 바로 답을 찾을 수 있습니다.
| 기록해 두어야 할 사항 | 필요한 이유 |
|---|---|
| 데이터베이스 및 검색어 | 방법론 섹션 작성 및 범위 관련 이의 제기 대응 |
| 각 스크리닝 단계별 문헌 수 | 선정 프로세스 재구성 |
| 선정 및 제외 기준 | 잘 알려진 논문이 누락된 이유 설명 |
| 도구를 사용한 단계 | AI 사용 공개 요구사항 충족 |
| 검증한 내용 및 방법 | 특정 수치에 대한 이의 제기 대응 |
이 워크플로우가 적합하지 않은 경우
위의 접근 방식이 오히려 일거리를 늘리는 경우를 짚고 넘어갈 가치가 있습니다.
5~6편의 논문을 검토할 때는 매트릭스가 필요하지 않습니다. 6편 정도는 머릿속에 담아둘 수 있으므로, 이를 위해 뼈대를 만드는 것은 배보다 배꼽이 더 클 수 있습니다.
축적된 연구 결과가 아니라 특정 이론적 전통 자체를 진지하게 논하는 문헌 고찰의 경우, 표 작성을 통한 이득이 적습니다. 텍스트 추출은 측정 가능한 주장에 효과적이며, 해석학적 관점을 다루는 데는 덜 효과적이기 때문입니다.
메타분석은 여기서 설명한 것보다 훨씬 더 엄격한 요구사항을 가집니다. 효과 크기, 이질성, 편향 위험 평가는 모두 확립된 프로토콜을 따르며, 추출 단계 역시 범용 열 구성이 아닌 해당 프로토콜을 충족해야 합니다.
또한 해당 분야에서 프로토콜 등록을 요구하는 경우, 추출을 시작하기 전에 등록하십시오. 사후에 등록하는 것은 본래의 목적을 퇴색시킵니다.
흔히 하는 실수들
논문별로 요약하기. 가장 흔한 구조적 실패 사례입니다. 이는 제목만 잘못 붙인 해제 서지(annotated bibliography)를 만들어낼 뿐입니다.
도구가 주제를 설정하게 두기. 평범한 열은 평범한 섹션을 만듭니다. 열은 여러분의 논증을 개요 형태로 나타낸 것입니다.
출력이 그럴듯해 보인다고 해서 검증을 건너뛰기. 매끄러운 추출과 정확한 추출은 서로 다른 속성이며, 그 차이는 방법론 섹션에서 고스란히 드러납니다.
검색 기록을 남기지 않기. 포함하지 않은 논문들도 방법론의 일부이며, 사후에 검색을 재구성하면 동일한 목록이 나오는 경우가 거의 없습니다.
확인 없이 인용구를 그대로 수용하기. 모든 참고문헌은 원문으로 돌아가 확인해야 합니다. 이는 타협할 수 없는 원칙이며, 잘못되었을 때 치러야 할 대가에 비하면 시간도 훨씬 적게 듭니다.
이견을 노이즈로 취급하기. 상충되는 연구 결과는 대부분의 문헌에서 가장 많은 정보를 제공하는 부분입니다.
서론부터 먼저 쓰기. 문헌 고찰의 프레임은 매트릭스가 보여주는 결과를 따라야지, 그보다 앞서서는 안 됩니다. 자료를 읽기 전에 작성된 서론은 증거가 뒷받침하지 않는 결론을 성급하게 내리는 경향이 있습니다.
과도하게 수집하기. 잘 선택된 40편의 논문이 광범위한 검색으로 모은 100편보다 낫습니다. 출처가 추가될 때마다 검증 시간이 소요되며, 지엽적인 논문들은 논증을 바꾸는 데 거의 기여하지 못합니다.
공백(gap) 섹션을 마지막까지 미뤄두고 서둘러 작성하기. 공백 섹션은 대개 문헌 고찰에서 가장 많이 인용되는 부분이며, 자정에 급하게 작성한 한 문단 이상의 가치를 지닙니다.
빠른 참조 가이드
| 단계 | 결과물 | AI를 통한 시간 단축 효과 |
|---|---|---|
| 질문 정의 | 경계가 명확하고 답할 수 있는 질문 | 없음 — 사용자의 몫 |
| 검색 및 스크리닝 | PDF 폴더 및 검색 기록 | 없음 — 데이터베이스 직접 검색 |
| 추출 | 내용이 채워진 종합 매트릭스 | 상당함 |
| 검증 | 검증이 완료된 매트릭스 | 없음 — 이전 행의 이점을 얻기 위한 대가 |
| 종합 | 그룹화된 입장 및 식별된 이견 | 상당함 |
| 작성 | 문헌 고찰 본문 | 보통 (초안 작성 기준) |
| 인용 | 검증된 참고문헌 | 없음 |
마지막 열에서 일정한 패턴을 볼 수 있습니다. AI의 도움은 양(volume)이 문제가 되는 중간 단계에 집중되어 있습니다. 시작과 끝은 수동으로 유지되는데, 그곳이 바로 판단력이 필요한 영역이기 때문입니다.
이 분야에 특화된 도구들에 대해서는 학술용 AI 도구 및 PDF 데이터 추출 및 분석을 위한 최고의 AI 도구 모음 글을 참고하십시오.
자주 묻는 질문
AI가 저를 대신해 문헌 고찰을 작성해 줄 수 있나요?
자료를 수집하고 검증한 후에는 AI가 각 섹션의 초안을 작성할 수 있으며, 여러 논문에 걸친 추출 및 비교 작업에 매우 강력한 성능을 발휘합니다. 하지만 연구 질문 설정, 조사 범위 보장, 정확성에 대한 책임이라는 세 가지는 여전히 여러분의 몫으로 남습니다. 심사위원은 이 세 가지 모두에 대해 여러분에게 책임을 물을 것입니다.
종합 매트릭스란 무엇인가요?
행은 출처(논문)이고 열은 주제나 변수인 표를 말합니다. 행을 가로로 읽으면 논문 한 편이 요약되고, 열을 세로로 읽으면 하나의 질문에 대해 해당 분야가 무엇을 말하는지 보여줍니다. 이는 읽기와 쓰기 사이의 표준적인 중간 단계입니다.
문헌 고찰에 AI를 사용하는 것이 허용되나요?
규정은 기관 및 학술지마다 다르며, 최근에는 AI 사용 방식을 공개하도록 요구하는 곳이 많습니다. 본인에게 적용되는 지침을 확인하고, 어떤 단계에서 도구를 사용했는지 기록해 두십시오. 결과의 정확성에 대한 책임은 어떤 경우에도 저자에게 있습니다.
PRISMA는 무엇을 요구하나요?
PRISMA는 체계적 문헌고찰을 위한 보고 지침입니다. 저자들에게 문헌 고찰을 수행한 이유, 사용된 방법론, 발견된 결과를 완전하게 보고할 것을 요구합니다. 확장판은 범위 고찰(scoping review)과 같은 다른 유형의 문헌 고찰도 다룹니다.
문헌 고찰에는 얼마나 많은 출처를 포함해야 하나요?
정해진 숫자는 없으며, 연구 범위와 분야에 따라 다릅니다. 더 중요한 것은 검색 및 스크리닝 프로세스가 기록되어 있고 방어 가능해야 한다는 점입니다. 독자가 무엇이 포함되고 무엇이 제외되었는지 명확히 알 수 있어야 합니다.
출처: PRISMA 성명, prisma-statement.org (PRISMA 2020 및 해당 확장판 포함).