AI के साथ थीमैटिक एनालिसिस कैसे करें: चरण-दर-चरण
थिमैटिक एनालिसिस (Thematic analysis) गुणात्मक डेटा (qualitative data), जैसे कि इंटरव्यू ट्रांसक्रिप्ट या ओपन-एंडेड सर्वे के जवाबों में अर्थ के पैटर्न खोजने का एक तरीका है। AI के साथ इसे करने के लिए, अपने ट्रांसक्रिप्ट और रिसर्च प्रश्न को लोड करें, AI को पहले-चरण के कोड (first-pass codes) प्रस्तावित करने दें, और फिर थीम को खुद विकसित और जांचें। AI पढ़ने और छांटने की प्रक्रिया को तेज कर देता है। व्याख्या (interpretation) का काम आपका ही रहता है।
यह गाइड बताती है कि थिमैटिक एनालिसिस क्या है, इसके छह चरणों के बारे में विस्तार से बताती है, और यह दिखाती है कि AI कहाँ मदद करता है और कहाँ इसे निर्णय नहीं लेना चाहिए। इसमें एक व्यावहारिक उदाहरण, परिणाम तालिका (results table) का प्रारूप और कंटेंट एनालिसिस (content analysis) के साथ तुलना शामिल है।
थिमैटिक एनालिसिस क्या है
वर्जीनिया ब्रौन (Virginia Braun) और विक्टोरिया क्लार्क (Victoria Clarke), जिन्होंने इस पद्धति के सबसे व्यापक रूप से उद्धृत संस्करण को विकसित किया है, अपनी साइट पर इसे इस प्रकार परिभाषित करते हैं। "थिमैटिक एनालिसिस (TA) गुणात्मक अनुसंधान विधियों (qualitative research methods) की एक श्रृंखला को संदर्भित करता है जिसका उपयोग डेटासेट में पैटर्न वाले अर्थों की खोज और व्याख्या करने के लिए किया जाता है।"
उस परिभाषा में दो शब्द बहुत महत्वपूर्ण हैं। "श्रृंखला" (Range) का अर्थ है कि थिमैटिक एनालिसिस दृष्टिकोणों का एक समूह है, न कि कोई एक निश्चित प्रक्रिया। "व्याख्या" (Interpreting) का अर्थ है कि इसका परिणाम इस बात का तर्क है कि डेटा का क्या अर्थ है, न कि इस बात की गिनती कि वह क्या कहता है.
ब्रौन और क्लार्क इस समूह को तीन श्रेणियों में विभाजित करते हैं: कोडिंग विश्वसनीयता दृष्टिकोण (coding reliability approaches), कोडबुक दृष्टिकोण (codebook approaches), और उनका अपना रिफ्लेक्सिव दृष्टिकोण (reflexive approach)। यह अंतर इस बात को प्रभावित करता है कि आप AI का उपयोग कैसे करते हैं।
- कोडिंग विश्वसनीयता (Coding reliability) शुरुआत में ही एक कोडबुक तय कर देती है और यह जांचती है कि अलग-अलग कोडर इसे एक ही तरह से लागू करें।
- कोडबुक (Codebook) दृष्टिकोण भी एक संरचित ढांचे का उपयोग करते हैं, लेकिन इसमें कुछ हद तक बदलाव की अनुमति होती है।
- रिफ्लेक्सिव थिमैटिक एनालिसिस (Reflexive thematic analysis) कोडिंग को खुला रखता है और जैसे-जैसे आपकी समझ गहरी होती है, इसमें बदलाव की अनुमति देता है। उनके FAQ में स्पष्ट रूप से कहा गया है कि "रिफ्लेक्सिव TA कोडबुक से बचता है।"
रिफ्लेक्सिव थिमैटिक एनालिसिस में, एक थीम किसी विषय (topic) से कहीं अधिक होती है। ब्रौन और क्लार्क थीम को "एक केंद्रीय अवधारणा या विचार पर आधारित साझा अर्थ के पैटर्न" के रूप में वर्णित करते हैं। "मूल्य निर्धारण" (pricing) जैसा विषय कोई थीम नहीं है। "ग्राहक कीमत को भरोसे के संकेत के रूप में देखते हैं" एक थीम है।
छह चरण
ब्रौन और क्लार्क छह चरणों की रूपरेखा तैयार करते हैं। वे इस बात पर जोर देते हैं कि "ये चरण किसी ऐसी कठोर प्रक्रिया को निर्धारित नहीं करते हैं जिसका आपको पालन करना ही पड़े।" व्यवहार में, आप इनके बीच आगे-पीछे होते रहते हैं।
- डेटासेट से खुद को परिचित करना। डेटा को बार-बार पढ़ें और शुरुआती टिप्पणियों को नोट करें।
- कोडिंग (Coding)। दो या दो से अधिक दौर में, पूरे डेटासेट में सार्थक हिस्सों पर छोटे लेबल लगाएं।
- शुरुआती थीम तैयार करना। कोड्स को अर्थ के संभावित पैटर्न में समूहित (cluster) करें।
- थीम विकसित करना और उनकी समीक्षा करना। कोडेड डेटा और पूरे डेटासेट के साथ प्रत्येक संभावित थीम की जांच करें। आवश्यकतानुसार थीम को विभाजित करें, मर्ज करें या हटा दें।
- थीम को परिष्कृत, परिभाषित और नाम देना। प्रत्येक थीम के दायरे और कहानी को समझें और उसे एक जानकारीपूर्ण नाम दें।
- रिपोर्ट लिखना (Writing up)। विश्लेषणात्मक विवरण को डेटा के अंशों के साथ जोड़ें, और इसे मौजूदा साहित्य से जोड़ें।
उनकी साइट इस प्रक्रिया का ईमानदारी से वर्णन करती: "विश्लेषण आमतौर पर एक पुनरावृत्ति (recursive) प्रक्रिया है।" थीम बनाना शुरू करने के बाद कोडिंग पर वापस लौटने के लिए तैयार रहें।
AI कहाँ मदद करता है और कहाँ इसे निर्णय नहीं लेना चाहिए
AI उन चरणों के लिए वास्तव में उपयोगी है जिनमें डेटा की मात्रा अधिक होती है। यह चालीस ट्रांसक्रिप्ट को जल्दी से पढ़ सकता है, संभावित कोड सुझा सकता है, किसी कोड में फिट होने वाले हर अंश को निकाल सकता है, और यह गिन सकता है कि कोई पैटर्न कितनी बार दिखाई देता है।
इसे व्याख्यात्मक निर्णय (interpretive calls) नहीं लेने चाहिए। ब्रौन और क्लार्क लिखते हैं कि "गुणात्मक विश्लेषण एक कुशल, परिस्थिति-आधारित और व्यक्तिपरक (subjective) प्रक्रिया है।" एक मॉडल का आपके शोध प्रश्न में कोई व्यक्तिगत हित नहीं होता है, और यह केवल उसी संदर्भ को जानता है जो आप इसे देते हैं।
उनका FAQ विश्लेषण सॉफ़्टवेयर के बारे में एक संबंधित बात बताता है। वे लिखते हैं कि जो बात मायने रखती है, वह है "एक जागरूक शोधकर्ता होना।" इसका अर्थ है किसी भी उपकरण का उपयोग इस तरह से करना जो आपके द्वारा चुने गए दृष्टिकोण के मूल्यों के अनुकूल हो।
एक व्यावहारिक विभाजन इस प्रकार दिखता है:
| चरण | AI क्या कर सकता है | आप क्या तय करते हैं |
|---|---|---|
| परिचित होना | प्रत्येक ट्रांसक्रिप्ट का सारांश तैयार करना, आश्चर्यजनक अंशों को चिह्नित करना | आपके प्रश्न के लिए कौन से अंश मायने रखते हैं |
| कोडिंग | पहले-चरण के कोड प्रस्तावित करना और उन्हें लगातार लागू करना | किन कोड्स को रखना है, मर्ज करना है या नाम बदलना है |
| थीम तैयार करना | कोड्स को समूहित करना और सहायक अंशों को निकालना | क्या कोई समूह अर्थ का वास्तविक पैटर्न है |
| थीम की समीक्षा करना | विपरीत उदाहरणों के लिए डेटासेट खोजना | क्या कोई थीम सही साबित होती है |
| थीम को नाम देना | नाम और एक-पंक्ति की परिभाषाएं सुझाना | अंतिम नाम और वह कहानी जो यह बताती है |
| रिपोर्ट लिखना | अनुभागों का मसौदा तैयार करना और उद्धरणों को इकट्ठा करना | तर्क और उसके दावे |
यदि आप कोडबुक दृष्टिकोण का उपयोग करते हैं, तो AI आउटपुट एक ड्राफ्ट कोडबुक के रूप में काम कर सकता है। यदि आप रिफ्लेक्सिव थिमैटिक एनालिसिस का उपयोग करते हैं, तो AI कोड्स को सोचने के लिए संकेत (prompts) के रूप में मानें, न कि स्वयं विश्लेषण के रूप में।
आप चाहे जो भी दृष्टिकोण अपनाएं, यह रिकॉर्ड करें कि AI इसमें कैसे शामिल था। टूल, जिन चरणों में इसने मदद की, और उसके बाद आपने क्या बदलाव किए, उन्हें नोट करें। एक छोटा कार्यप्रणाली (methods) पैराग्राफ किसी समीक्षक, परीक्षक या हितधारक (stakeholder) के पूछने से पहले ही उनके प्रश्न का उत्तर दे देता है।
शुरू करने से पहले आपको क्या चाहिए
किसी भी AI टूल द्वारा डेटा को छूने से पहले चार चीजें तैयार करें।
एक स्पष्ट शोध प्रश्न। हर कोड और थीम का मूल्यांकन इसी के आधार पर किया जाता है। "ऑनबोर्डिंग के दौरान ग्राहकों का क्या अनुभव होता है?" से "ग्राहक पहले महीने में क्यों रद्द (cancel) करते हैं?" की तुलना में एक अलग विश्लेषण तैयार होता है।
साफ, पहचान-रहित (de-identified) ट्रांसक्रिप्ट। नाम, कंपनी के नाम, ईमेल और किसी भी ऐसे विवरण को हटा दें जो किसी प्रतिभागी की पहचान उजागर करता हो। ऐसा अपलोड करने से पहले करें, बाद में नहीं। तीसरे पक्ष (third-party) के उपकरणों पर किसी भी सीमा के लिए अपनी नैतिक स्वीकृति (ethics approval) या सहमति पत्रों की जांच करें।
अपने स्वयं के विचारों के लिए एक नोट्स दस्तावेज़। रिफ्लेक्सिव थिमैटिक एनालिसिस शोधकर्ता के दृष्टिकोण को प्रमुखता देता है। पढ़ते समय अपनी मान्यताओं और प्रतिक्रियाओं का एक निरंतर रिकॉर्ड रखें, जो AI द्वारा तैयार की गई किसी भी चीज़ से अलग हो।
एक सुसंगत फ़ाइल प्रारूप (file format)। प्रति इंटरव्यू एक फ़ाइल, जिसमें वक्ता के लेबल (speaker labels) हों, प्रत्येक अंश को उसके स्रोत तक वापस ट्रैक करना आसान बनाती है। एक सरल इंडेक्स रखें जो प्रतिभागी कोड को इंटरव्यू की तारीखों से जोड़ता हो।
AI के साथ थिमैटिक एनालिसिस कैसे करें
नीचे दिए गए चरण छह चरणों का पालन करते हैं, जिन्हें तीन कार्य सत्रों (working sessions) में समूहित किया गया है।
चरण 1: ट्रांसक्रिप्ट लोड करें और शोध प्रश्न निर्धारित करें
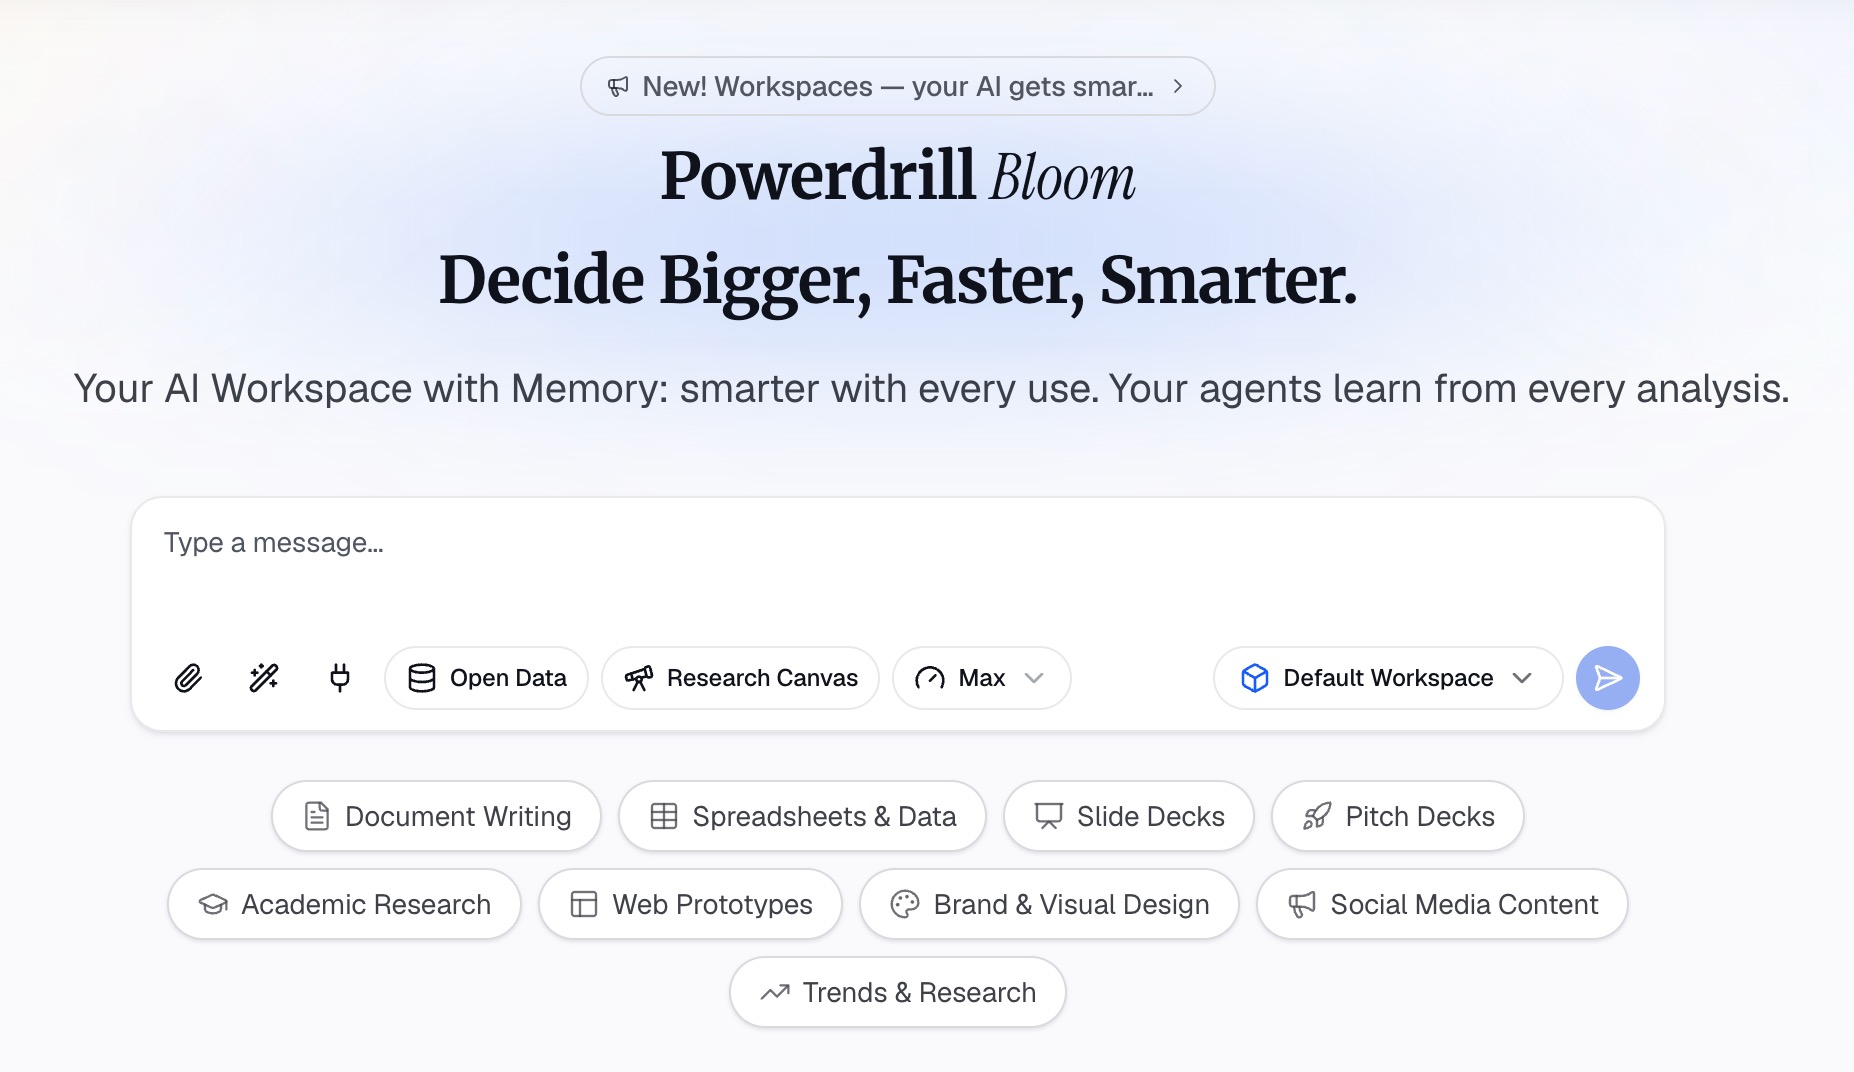
पहचान-रहित ट्रांसक्रिप्ट को Powerdrill Bloom जैसे AI वर्कस्पेस पर अपलोड करें। इसकी योजनाओं में Excel, CSV, PDF और डॉक्स के अपलोड शामिल हैं, इसलिए Word या PDF में ट्रांसक्रिप्ट वैसे ही काम करते हैं जैसे वे हैं। स्प्रेडशीट में निर्यात (export) किए गए ओपन-एंडेड सर्वे के जवाब भी काम करते हैं।
किसी भी अनुरोध से पहले, सबसे पहले शोध प्रश्न बताएं। फिर प्रत्येक ट्रांसक्रिप्ट का एक संक्षिप्त सारांश और प्रश्न से संबंधित अंशों की एक सूची मांगें।
उन सारांशों को पढ़ें, फिर खुद ट्रांसक्रिप्ट पढ़ें। AI सारांश परिचित होने की प्रक्रिया को तेज करते हैं, लेकिन वे इसका विकल्प नहीं हैं। किसी भी AI-जनरेटेड कोड को देखने से पहले एक अलग दस्तावेज़ में अपने खुद के पहले प्रभाव (first impressions) नोट करें।
चरण 2: पहले-चरण के कोड जनरेट करें, फिर खुद दोबारा कोडिंग करें
AI से प्रत्येक ट्रांसक्रिप्ट के लिए कोड प्रस्तावित करने के लिए कहें। छोटे लेबल, प्रत्येक के लिए एक-पंक्ति की परिभाषा और उनका समर्थन करने वाले सटीक अंशों (exact extracts) की मांग करें।
एक उपयोगी अनुरोध संक्षिप्त और विशिष्ट होता है। शोध प्रश्न से संबंधित किसी भी चीज़ के लिए ट्रांसक्रिप्ट को कोड करें, लेबल को पांच शब्दों से कम रखें, और प्रत्येक के लिए सटीक अंश को उद्धृत करें। सटीक अंशों की मांग करने से ऐसे कोड को पहचानना आसान हो जाता है जो प्रतिभागी द्वारा वास्तव में कही गई बात से भटक गया हो।
फिर अपने आप कोडिंग का दूसरा दौर करें। अपने कोड्स की तुलना AI की सूची से करें। जहाँ वे सहमत होते हैं, वहाँ कोड शायद किसी ऐसी चीज़ का वर्णन कर रहा है जो स्पष्ट रूप से मौजूद है। जहाँ वे भिन्न होते हैं, वहाँ बारीक से देखें। या तो AI ने किसी ऐसी चीज़ पर ध्यान दिया है जिसे आपने छोड़ दिया था, या उसने अर्थ के बजाय केवल सतही शब्दों को लेबल किया है।
हर अंश को ट्रैक करने योग्य (traceable) रखें। प्रत्येक कोड को एक प्रतिभागी और एक अंश की ओर इशारा करना चाहिए। Powerdrill Bloom का होमपेज कहता है कि हर संख्या "पेज, रो (row) और उसके पीछे के आंकड़े के साथ वापस आती है," और यही ट्रैसेबिलिटी उद्धरणों (quotes) के लिए भी मायने रखती है।
चरण 3: संभावित थीम बनाएं और डेटा के साथ उनकी जांच करें
AI से अपने अंतिम कोड्स को संभावित थीम में समूहित करने के लिए कहें, साथ ही प्रत्येक के लिए सहायक अंश भी मांगें। इन समूहों को एक शुरुआती बिंदु के रूप में मानें।
प्रत्येक संभावित थीम के लिए, एक प्रश्न पूछें: क्या इसके पीछे कोई केंद्रीय अवधारणा या विचार है? यदि उत्तर केवल एक साझा विषय है, तो यह अभी तक कोई थीम नहीं है। इसे विभाजित करें, मर्ज करें या हटा दें।
फिर प्रत्येक थीम का परीक्षण करें। AI से ऐसे अंश खोजने के लिए कहें जो इसका खंडन करते हों। विपरीत उदाहरणों की जानबूझकर की गई खोज में जो थीम बची रहती है, वह उस थीम से अधिक मजबूत होती है जिसे कभी चुनौती नहीं दी गई थी।
अंत में, प्रत्येक थीम को नाम दें और दो-वाक्यों की परिभाषा लिखें। अनुभाग दर अनुभाग रिपोर्ट का मसौदा तैयार करें, और रिपोर्ट में शामिल करने से पहले मूल ट्रांसक्रिप्ट के साथ हर उद्धरण की जांच करें।
एक व्यावहारिक उदाहरण
यहाँ बारह ग्राहक इंटरव्यू के साथ एक उत्पाद अनुसंधान अध्ययन (product research study) पर प्रक्रिया का एक संक्षिप्त संस्करण दिया गया है। शोध प्रश्न में पूछा गया था कि नए ग्राहकों ने 30 दिनों के भीतर उत्पाद का उपयोग करना क्यों बंद कर दिया।
पहले-चरण के AI कोड्स में "सेटअप में बहुत अधिक समय लगा," "अस्पष्ट मूल्य निर्धारण," और "IT अनुमोदन की आवश्यकता थी" शामिल थे।
कोडिंग के दूसरे दौर के बाद, शोधकर्ता ने देखा कि ये तीनों उन लोगों के इंटरव्यू में दिखाई दिए जिन्होंने खुद उत्पाद का चयन नहीं किया था।
इसके परिणामस्वरूप जो थीम सामने आई वह थी "स्वामित्व के बिना अपनाना" (adoption without ownership)। जिन ग्राहकों को यह उत्पाद विरासत में मिला था, उनके पास शुरुआती दिक्कतों से पार पाने का कोई कारण नहीं था।
शोधकर्ता ने फिर AI से विपरीत उदाहरण मांगे: ऐसे ग्राहक जिन्होंने उत्पाद का चयन नहीं किया था लेकिन फिर भी बने रहे। दो इंटरव्यू इसमें फिट बैठे। दोनों ने एक ऐसे सहकर्मी का वर्णन किया जिसने उन्हें पहले सप्ताह में एक त्वरित लाभ (quick win) दिखाया था, जिसने थीम को तोड़ने के बजाय उसे और परिष्कृत किया।
AI ने कोड्स को जल्दी से सामने ला दिया। थीम शोधकर्ता के इस ध्यान देने से आई कि उन्हें कौन कह रहा था, जिसे कोई भी कोड अपने आप में कैप्चर नहीं कर सकता था।
थिमैटिक एनालिसिस के परिणामों को कैसे प्रस्तुत करें
एक परिणाम अनुभाग (results section) आमतौर पर थीम की एक तालिका के साथ शुरू होता है, फिर सहायक अंशों के साथ प्रत्येक थीम पर चर्चा करता है। नीचे दी गई तालिका एक सामान्य प्रारूप दिखाती है।
| थीम | परिभाषा | प्रतिभागी | उदाहरण अंश |
|---|---|---|---|
| स्वामित्व के बिना अपनाना (Adoption without ownership) | जिन उपयोगकर्ताओं ने उत्पाद का चयन नहीं किया था, उनके पास बने रहने का बहुत कम कारण था | 12 में से 7 | "मुझे इसका उपयोग करने के लिए कहा गया था, इसलिए मैंने न्यूनतम काम किया।" |
| पहली छाप के रूप में सेटअप (Setup as a first impression) | शुरुआती सेटअप के प्रयास ने उत्पाद के प्रति समग्र दृष्टिकोण को आकार दिया | 12 में से 9 | "यदि पहला घंटा कठिन है, तो आप मान लेते हैं कि बाकी भी ऐसा ही होगा।" |
तालिका के बाद प्रत्येक थीम के लिए एक छोटा अनुभाग रखें। केंद्रीय विचार को समझाएं, दो या तीन अंश दिखाएं, और इसे अपने शोध प्रश्न से जोड़ें।
ऐसे अंश चुनें जो थीम को अलग-अलग कोणों से दिखाते हों, न कि तीन ऐसे उद्धरण जो एक ही बात कह रहे हों। उन्हें छोटा रखें, और हमेशा उन्हें एक प्रतिभागी कोड के साथ जोड़ें। पाठक किसी थीम पर तब अधिक भरोसा करते हैं जब वे इसे कई आवाजों में देख सकते हैं।
प्रतिभागियों की संख्या सहायक संदर्भ है, लेकिन ब्रौन और क्लार्क का दृष्टिकोण आवृत्ति (frequency) को महत्व के पैमाने के रूप में नहीं मानता है। चार लोगों द्वारा उल्लिखित थीम दस लोगों द्वारा उल्लिखित थीम से अधिक महत्वपूर्ण हो सकती है।
हितधारक (stakeholder) दर्शकों के लिए, यही परिणाम अक्सर एक संक्षिप्त डेक (deck) बन जाते हैं। AI research synthesis टूल इस मार्ग का वर्णन करता है, जो ट्रांसक्रिप्ट और सर्वेक्षणों को थीम, साक्ष्य और एक हितधारक डेक में जोड़ता है।
थिमैटिक एनालिसिस बनाम कंटेंट एनालिसिस
इन दोनों विधियों में अक्सर भ्रम होता है क्योंकि दोनों गुणात्मक डेटा (qualitative data) के साथ काम करती हैं।
| थिमैटिक एनालिसिस | कंटेंट एनालिसिस | |
|---|---|---|
| मुख्य लक्ष्य | अर्थ के पैटर्न की व्याख्या करना | सामग्री को वर्गीकृत करना और अक्सर उसकी गिनती करना |
| परिणाम (Output) | एक केंद्रीय विचार वाली थीम | आवृत्तियों (frequencies) के साथ श्रेणियां |
| गिनती की भूमिका | अधिकतम सहायक संदर्भ | अक्सर केंद्रीय |
| किसके लिए सर्वोत्तम है | अनुभवों और विचारों को समझने के लिए | कोई चीज़ कितनी बार दिखाई देती है, इसे मापने के लिए |
यदि आपका प्रश्न है "ग्राहक कितनी बार मूल्य निर्धारण का उल्लेख करते हैं?", तो कंटेंट एनालिसिस उपयुक्त है। यदि यह है "ग्राहकों के लिए मूल्य निर्धारण का क्या अर्थ है?", तो थिमैटिक एनालिसिस उपयुक्त है।
कुछ परियोजनाएं क्रम में दोनों का उपयोग करती हैं। एक बड़े डेटासेट में आवृत्ति की जांच (frequency pass) यह दिखाती है कि डेटा की मात्रा कहाँ है। फिर एक छोटे, केंद्रित नमूने (sample) पर थिमैटिक जांच यह बताती है कि उस मात्रा का क्या अर्थ है।
बड़े पैमाने पर फीडबैक के लिए, जैसे कि हजारों समीक्षाएं या सपोर्ट टिकट, अक्सर आवृत्ति दृश्य (frequency view) पहली आवश्यकता होती है। Voice of Customer Summarizer फीडबैक चैनलों को आवृत्ति और प्रत्येक के लिए एक प्रतिनिधि शब्दशः (verbatim) के साथ थीम में बदल देता है।
Excel में थिमैटिक एनालिसिस
कई शोधकर्ता अभी भी स्प्रेडशीट में कोडिंग करते हैं, और यह छोटे अध्ययनों के लिए अच्छी तरह से काम करता है। एक सरल लेआउट प्रति अंश एक पंक्ति का उपयोग करता है।
- कॉलम A: प्रतिभागी कोड।
- कॉलम B: अंश, बिल्कुल वैसे ही कॉपी किया गया।
- कॉलम C: पहले दौर का कोड।
- कॉलम D: दूसरे दौर का कोड।
- कॉलम E: संभावित थीम।
थीम के आधार पर फ़िल्टर करने से आपको एक ही बार में हर सहायक अंश मिल जाता है। प्रति थीम और प्रति प्रतिभागी पंक्तियों की संख्या भी एक नज़र में यह दिखाती है कि क्या कोई थीम केवल एक बातूनी साक्षात्कारकर्ता (interviewee) पर निर्भर है। इसकी सीमा पैमाना (scale) है। कुछ सौ से अधिक अंशों के बाद, हाथ से छांटना और दोबारा कोडिंग करना धीमा हो जाता है, यही वह जगह है जहाँ AI-सहायता प्राप्त समूहन (clustering) सबसे अधिक समय बचाता है।
यदि आपकी परियोजना में प्रकाशित अध्ययनों की समीक्षा भी शामिल है, तो AI के साथ साहित्य समीक्षा (literature review) लिखने की हमारी गाइड उस हिस्से को कवर करती है।
सामान्य गलतियाँ
- विषयों (topics) को थीम मानना। "संचार" (Communication) एक विषय है। थीम इसके बारे में कुछ कहती है।
- दूसरे दौर के बिना AI कोड्स को स्वीकार करना। पहले-चरण के कोड अक्सर अर्थ के बजाय शब्दों को लेबल करते हैं।
- पहचान योग्य डेटा अपलोड करना। किसी भी अपलोड से पहले ट्रांसक्रिप्ट को पहचान-रहित (de-identify) करें।
- गिनती को प्रमाण मानना। आवृत्ति किसी थीम का समर्थन करती है, लेकिन यह उसे स्थापित नहीं करती है।
- विपरीत उदाहरणों की खोज को छोड़ना। जिस थीम को कभी चुनौती नहीं दी गई, वह दिखने में जितनी मजबूत लगती है, उतनी होती नहीं है।
- AI को थीम का नाम देने देना। नाम तर्क को आगे बढ़ाते हैं, इसलिए थीम तय और परिभाषित होने के बाद उन्हें खुद लिखें।
इन्हें सही तरीके से करना ही एक विश्वसनीय विश्लेषण को शीर्षकों वाले सारांश से अलग करता है। यदि आप अपने खुद के ट्रांसक्रिप्ट पर पढ़ना, कोडिंग और समूहन तेजी से करना चाहते हैं, तो आप एक अध्ययन के साथ Powerdrill Bloom आज़मा सकते हैं।
अक्सर पूछे जाने वाले प्रश्न
सरल शब्दों में थिमैटिक एनालिसिस क्या है?
थिमैटिक एनालिसिस गुणात्मक डेटा (qualitative data), जैसे कि इंटरव्यू, में अर्थ के पैटर्न खोजने और उनकी व्याख्या करने का एक तरीका है। शोधकर्ता डेटा को कोड करता है, कोड्स को थीम में समूहित करता है, और यह बताता है कि प्रत्येक थीम शोध प्रश्न के बारे में क्या कहती है।
थिमैटिक एनालिसिस के छह चरण क्या हैं?
ब्रौन और क्लार्क के छह चरण हैं: डेटासेट से खुद को परिचित करना, कोडिंग, शुरुआती थीम तैयार करना, थीम विकसित करना और उनकी समीक्षा करना, और थीम को परिष्कृत, परिभाषित और नाम देना। छठा चरण रिपोर्ट लिखना है। वे ध्यान दिलाते हैं कि ये चरण कोई कठोर नियम नहीं हैं।
क्या AI थिमैटिक एनालिसिस कर सकता है?
AI अधिक मात्रा वाले काम में मदद कर सकता है, जैसे कि ट्रांसक्रिप्ट का सारांश तैयार करना, कोड प्रस्तावित करना और अंश निकालना। थीम का क्या अर्थ है, यह तय करने के व्याख्यात्मक काम के लिए अभी भी शोधकर्ता की आवश्यकता होती है। ब्रौन और क्लार्क गुणात्मक विश्लेषण को एक कुशल, परिस्थिति-आधारित और व्यक्तिपरक प्रक्रिया के रूप में वर्णित करते हैं।
एक थिमैटिक एनालिसिस में कितनी थीम होनी चाहिए?
ब्रौन और क्लार्क कहते हैं कि "TA में थीम की संख्या निर्धारित करने का कोई सटीक फॉर्मूला नहीं है।" यह डेटा, शोध प्रश्न और रिपोर्ट की लंबाई पर निर्भर करता है। एक विश्लेषण गहराई से एक थीम की रिपोर्ट कर सकता है या व्यापक अवलोकन प्रदान कर सकता है।
थिमैटिक एनालिसिस और कंटेंट एनालिसिस में क्या अंतर है?
थिमैटिक एनालिसिस अर्थ के पैटर्न की व्याख्या करता है और थीम तैयार करता है। कंटेंट एनालिसिस सामग्री को वर्गीकृत करता है और अक्सर यह गिनता है कि श्रेणियां कितनी बार दिखाई देती हैं। अनुभवों को समझने के लिए थिमैटिक एनालिसिस चुनें, और आवृत्ति को मापने के लिए कंटेंट एनालिसिस चुनें।
स्रोत: Braun and Clarke, Thematic Analysis · Understanding TA · Doing Reflexive TA · Thematic Analysis FAQs. व्यावहारिक उदाहरण और परिणाम तालिका केवल समझाने के उद्देश्य से हैं।