डेटा क्लीनिंग और प्रिपरेशन के लिए 10 सर्वश्रेष्ठ AI टूल्स (2026 के लिए तुलना)

डेटा आधुनिक व्यवसाय की जीवनधारा है, लेकिन raw data शायद ही कभी तत्काल उपयोग के लिए तैयार होता है। इससे पहले कि आप सार्थक अंतर्दृष्टि प्राप्त कर सकें, पूर्वानुमानित मॉडल बना सकें, या व्यापक रिपोर्ट तैयार कर सकें, आपको raw datasets की अव्यवस्थित वास्तविकता से निपटना होगा। अधूरे रिकॉर्ड, असंगत formatting, डुप्लिकेट और स्पष्ट विसंगतियाँ आपके विश्लेषण के प्रयासों को गंभीर रूप से बाधित कर सकती हैं। पारंपरिक रूप से, डेटा की सफाई और तैयारी के लिए थकाऊ, मैन्युअल स्प्रेडशीट हेरफेर या जटिल कोडिंग के घंटों की आवश्यकता होती थी।
आज, आर्टिफिशियल इंटेलिजेंस (AI) ने इस प्रक्रिया में पूरी तरह से क्रांति ला दी है। AI-संचालित प्लेटफॉर्मों का लाभ उठाकर, संगठन डेटा तैयारी के सबसे अधिक समय लेने वाले पहलुओं को स्वचालित कर सकते हैं, जिससे अराजक डेटा को बहुत कम समय में प्राचीन, व्यावहारिक संपत्तियों में बदला जा सकता है।
इस गाइड में, हम डेटा की सफाई और तैयारी के लिए उपलब्ध शीर्ष AI टूल का पता लगाएंगे, जिससे आपको अपने वर्कफ़्लो के लिए सही समाधान खोजने में मदद मिलेगी।
AI डेटा क्लीनिंग और प्रिपरेशन क्या है
AI डेटा क्लीनिंग और प्रिपरेशन से तात्पर्य raw data को स्वचालित रूप से व्यवस्थित, सही और प्रारूपित करने के लिए मशीन लर्निंग, natural language processing (NLP), और उन्नत एल्गोरिदम के उपयोग से है। मैन्युअल नियमों पर भरोसा करने के बजाय, AI सिस्टम आपके डेटा के संदर्भ को समझते हैं।
इंटेलिजेंट विसंगति पहचान (Intelligent Anomaly Detection): AI एल्गोरिदम मानवीय आँखों से छूट जाने वाली बाहरी कड़ियों (outliers), असंगतियों या त्रुटियों की पहचान करने के लिए विशाल डेटासेट को तुरंत स्कैन कर सकते हैं।
स्वचालित डेटा प्रतिस्थापन (Automated Data Imputation): लापता जानकारी वाली पंक्तियों को केवल हटाने के बजाय, AI ऐतिहासिक पैटर्न और संदर्भ के आधार पर लापता मानों (missing values) की भविष्यवाणी कर सकता है और उन्हें भर सकता है।
Natural Language Processing (NLP): उन्नत उपकरण उपयोगकर्ताओं को जटिल SQL या Python स्क्रिप्ट की आवश्यकता को दरकिनार करते हुए, केवल संवादात्मक कमांड टाइप करके डेटा को साफ और हेरफेर करने की अनुमति देते हैं।
स्मार्ट डीडुप्लीकेशन (Smart Deduplication): AI फ़ज़ी लॉजिक का उपयोग करके सटीक-मिलान फ़िल्टरिंग से आगे जाता है ताकि उन डुप्लिकेट रिकॉर्ड की पहचान की जा सके और उन्हें मर्ज किया जा सके जिनमें मामूली वर्तनी (spelling) या formatting भिन्नताएं हैं।
पूर्वानुमानित स्कीमा मैपिंग (Predictive Schema Mapping): AI स्वचालित रूप से विभिन्न स्रोतों से डेटा को एक एकीकृत, मानकीकृत प्रारूप में मैप करता है, जिससे डेटाबेस एकीकरण निर्बाध हो जाता है।
हमने सर्वश्रेष्ठ AI डेटा क्लीनिंग टूल्स का चयन कैसे किया
भीड़भाड़ वाले बाजार में सही सॉफ़्टवेयर चुनने के लिए एक सख्त मूल्यांकन प्रक्रिया की आवश्यकता होती है। हमने निम्नलिखित मानदंडों के आधार पर आपको सर्वोत्तम विकल्प प्रदान करने के लिए दर्जनों प्लेटफार्मों का विश्लेषण किया:
AI एकीकरण और स्वचालन (AI Integration and Automation): हमने उन उपकरणों को प्राथमिकता दी जो केवल पारंपरिक नियम-आधारित फ़िल्टर की पेशकश करने के बजाय मैन्युअल श्रम को कम करने के लिए वास्तव में आर्टिफिशियल इंटेलिजेंस का लाभ उठाते हैं।
उपयोग में आसानी और पहुंच (Ease of Use and Accessibility): सर्वोत्तम उपकरण गैर-तकनीकी उपयोगकर्ताओं को सशक्त बनाते हैं। हमने सहज ज्ञान युक्त इंटरफेस, प्राकृतिक भाषा क्षमताओं और विज़ुअल वर्कफ़्लो की खोज की।
एंड-टू-एंड वर्कफ़्लो क्षमताएं (End-to-End Workflow Capabilities): हमने उन प्लेटफार्मों का समर्थन किया जो एक ही स्थान पर डेटा विश्लेषण, विज़ुअलाइज़ेशन और रिपोर्ट जनरेशन की पेशकश करने के लिए सरल डेटा स्क्रबिंग से आगे जाते हैं।
स्केलेबिलिटी और प्रदर्शन (Scalability and Performance): हमने मूल्यांकन किया कि प्रत्येक उपकरण बिना क्रैश या धीमे हुए बड़े, जटिल डेटासेट को कितनी अच्छी तरह संभालता है।
मेमोरी और संदर्भ प्रतिधारण (Memory and Context Retention): हमने उन्नत सुविधाओं की तलाश की, जैसे कि पिछले प्रोजेक्ट्स को याद रखने और विभिन्न कार्य सत्रों में संदर्भ बनाए रखने की क्षमता।
तुलना: डेटा क्लीनिंग और प्रिपरेशन के लिए 10 सर्वश्रेष्ठ AI टूल्स
विस्तृत प्रोफाइल में गोता लगाने से पहले, यहाँ 10 सर्वश्रेष्ठ AI डेटा क्लीनिंग टूल्स की एक त्वरित तुलना तालिका दी गई है.
| उत्पाद | इसके लिए सर्वश्रेष्ठ | प्रमुख AI विशेषता | मूल्य निर्धारण मॉडल |
|---|---|---|---|
| 1. Powerdrill Bloom | ऑल-इन-वन डेटा क्लीनिंग, विश्लेषण और निष्पादन | Natural language processing और MemoryLake | $13.27/माह |
| 2. Dataiku | एंटरप्राइज डेटा साइंस टीमें | ऑटो-क्लीनिंग रेसिपी और ML मॉडल | कस्टम |
| 3. Alteryx | उन्नत स्थानिक (spatial) और स्वचालित तैयारी | पूर्वानुमानित डेटा प्रोफाइलिंग | कस्टम |
| 4. Matillion | क्लाउड डेटा वेयरहाउस एकीकरण | AI-संचालित ETL प्रक्रियाएं | कस्टम |
| 5. Integrate.io | ई-कॉमर्स और मार्केटिंग डेटा | स्मार्ट स्कीमा मैपिंग | कस्टम |
| 6. Tamr | मास्टर डेटा प्रबंधन (MDM) | मशीन लर्निंग डीडुप्लीकेशन | कस्टम |
| 7. Datameer | Snowflake उपयोगकर्ता | AI-सहायता प्राप्त SQL जनरेशन | कस्टम |
| 8. KNIME | ओपन-सोर्स डेटा साइंस | AI एक्सटेंशन नोड्स | कस्टम |
| 9. Zoho DataPrep | Zoho इकोसिस्टम उपयोगकर्ता और SMBs | AI-संचालित ऑटो-क्लींजिंग (Zia) | $50/माह |
| 10. Tableau Prep | Tableau इकोसिस्टम उपयोगकर्ता | स्मार्ट डेटा ग्रुपिंग और प्रोफाइलिंग | $15/माह |
1. Powerdrill Bloom
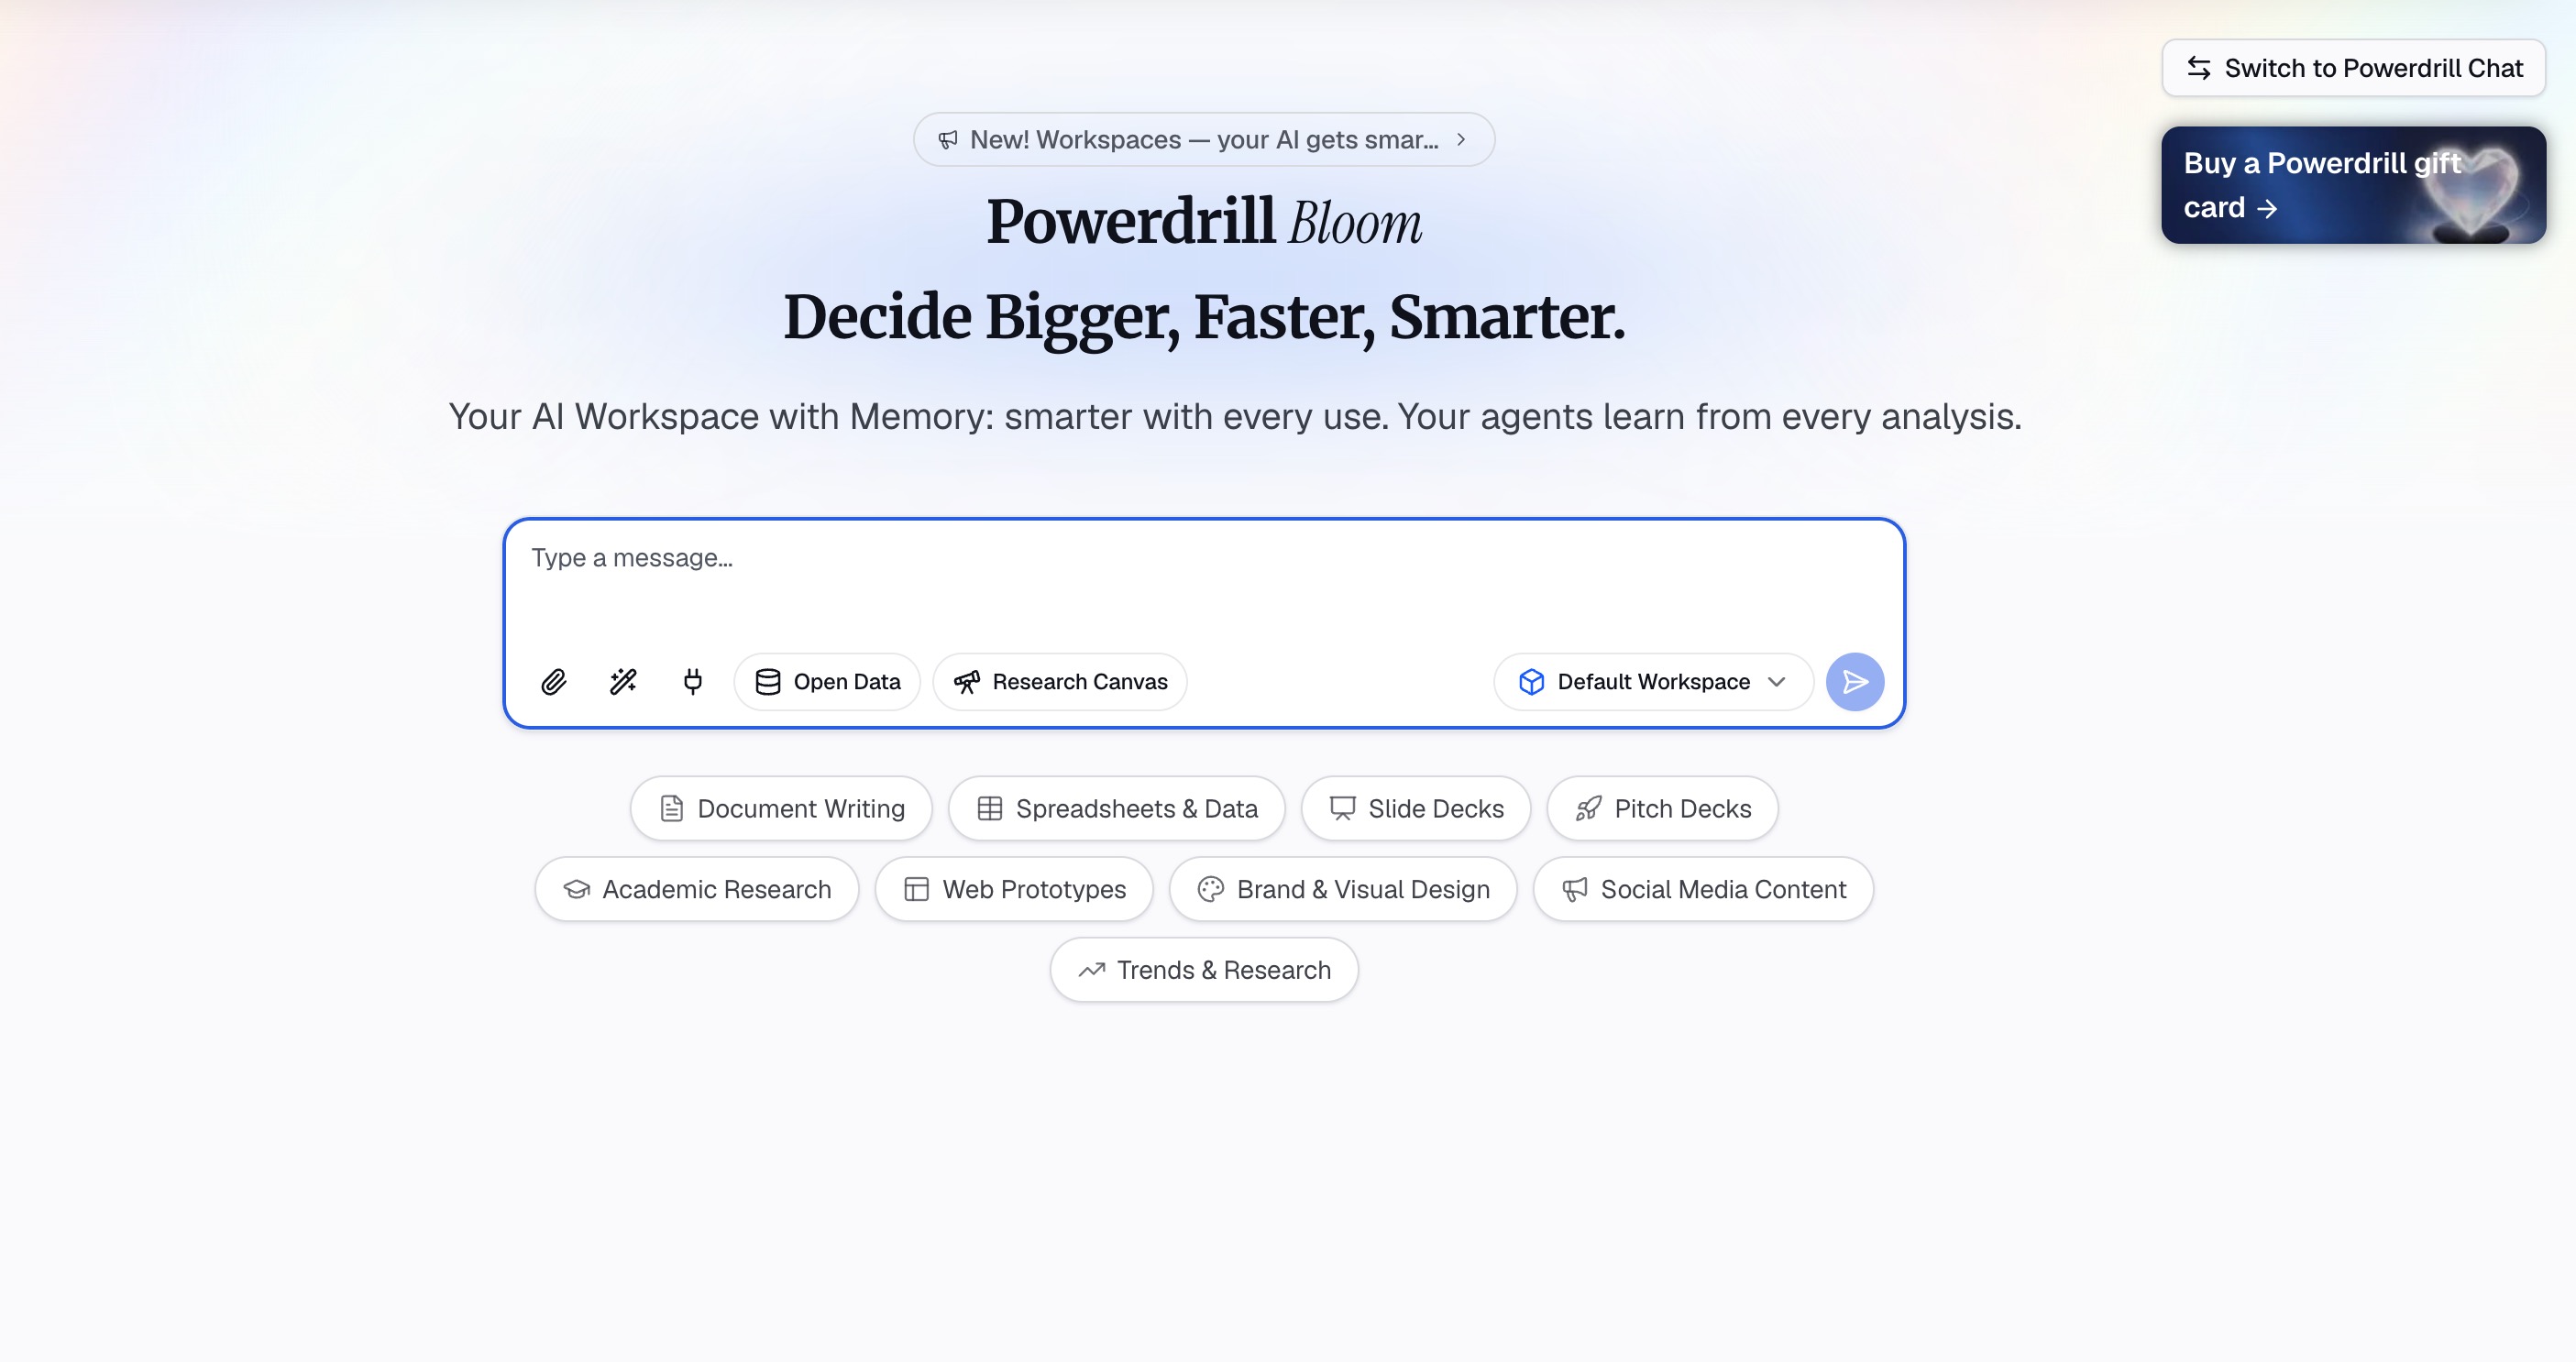
Powerdrill Bloom एक AI-संचालित वर्कस्पेस है जिसे उपयोगकर्ताओं को डेटा, फ़ाइलों और जानकारी को व्यावहारिक अंतर्दृष्टि और परिणामों में बदलने में मदद करने के लिए डिज़ाइन किया गया है। केवल सवालों के जवाब देने के बजाय, Bloom पूरे वर्कफ़्लो में भाग ले सकता है, अनुसंधान, डेटा तैयारी, सामग्री संगठन, रिपोर्ट जनरेशन और कार्य निष्पादन में मदद कर सकता है। raw data से लेकर अंतर्दृष्टि, विज़ुअलाइज़ेशन, रिपोर्ट और निष्पादन तक, Powerdrill Bloom कई AI-संचालित वर्कफ़्लो को एक जुड़े हुए वर्कस्पेस में एक साथ लाता है।
मुख्य विशेषताएं
प्राकृतिक भाषा डेटा इंटरैक्शन (Natural Language Data Interaction): उपयोगकर्ता CSV, Excel और अन्य फ़ाइलें अपलोड कर सकते हैं और अपने डेटा को साफ, प्रारूपित (format) और संरचित करने के लिए सरल अंग्रेजी कमांड का उपयोग करके सीधे बातचीत कर सकते हैं।
स्थायी वर्कस्पेस और MemoryLake (Persistent Workspaces & MemoryLake): स्थायी वर्कस्पेस प्रदान करता है जहाँ उपयोगकर्ता सत्रों (sessions) में फ़ाइलों, परियोजनाओं और संदर्भों को व्यवस्थित रख सकते हैं। MemoryLake के साथ इसका एकीकरण दीर्घकालिक मेमोरी को बढ़ाता है, जिससे Bloom को बिना शुरुआत से शुरू किए समय के साथ प्रासंगिक संदर्भ को बेहतर ढंग से समझने और बनाए रखने की अनुमति मिलती है।
स्वचालित विसंगति और प्रवृत्ति पहचान (Automated Anomaly & Trend Detection): Bloom रुझानों और विसंगतियों की पहचान करने के लिए स्वचालित रूप से डेटासेट का विश्लेषण करता है, जिससे सफाई की आवश्यकता वाली डेटा असंगतियों को उजागर करने के साथ-साथ प्रमुख अंतर्दृष्टि का पता चलता है।
एंड-टू-एंड कार्य निष्पादन (End-to-End Task Execution): डेटा सफाई से परे, यह चार्ट, विज़ुअल रिपोर्ट, प्रस्तुति-तैयार सामग्री उत्पन्न करने और जटिल अनुसंधान कार्यों को स्वचालित करने के लिए विशेष AI Skills का समर्थन करता है।
फायदे
अपने संवादात्मक प्राकृतिक भाषा इंटरफ़ेस के साथ सीखने की प्रक्रिया (learning curve) को पूरी तरह से समाप्त कर देता है।
MemoryLake के माध्यम से दीर्घकालिक संदर्भ बनाए रखता है, जिससे यह सुनिश्चित होता है कि आपके डेटा सफाई नियम और प्राथमिकताएं सत्रों में याद रखी जाएं।
एक ऑल-इन-वन वर्कस्पेस के रूप में कार्य करता है—आप ऐप्स स्विच किए बिना डेटा को साफ कर सकते हैं, उसका विश्लेषण कर सकते हैं और एक शानदार रिपोर्ट तैयार कर सकते हैं।
नुकसान
चूंकि यह क्लाउड-आधारित AI प्रोसेसिंग पर निर्भर करता है, इसलिए इंटरनेट कनेक्शन की सख्त आवश्यकता होती है।
पहले डेटा को CSV या Excel में निर्यात किए बिना पुराने ऑन-प्रिमाइसेस डेटाबेस का समर्थन नहीं कर सकता है।
मूल्य निर्धारण
निःशुल्क परीक्षण (Free trial); सशुल्क योजना $13.27/माह से शुरू होती है।
2. Dataiku
Dataiku एक व्यापक, केंद्रीकृत डेटा प्लेटफ़ॉर्म है जो डेटा इंजीनियरों, डेटा वैज्ञानिकों और व्यावसायिक विश्लेषकों के बीच की खाई को पाटता है। इसे AI के लोकतंत्रीकरण के लिए व्यापक रूप से मान्यता प्राप्त है, जो मजबूत डेटा तैयारी उपकरण प्रदान करता है जो उन्नत मशीन लर्निंग पाइपलाइनों में निर्बाध रूप से मिश्रित होते हैं।
मुख्य विशेषताएं
स्मार्ट पैटर्न पहचान (Smart Pattern Recognition): स्वचालित रूप से डेटा प्रकारों का अनुमान लगाता है और संदर्भ-जागरूक सफाई चरणों का सुझाव देता है।
विज़ुअल डेटा प्रेप रेसिपी (Visual Data Prep Recipes): विज़ुअल डेटा ट्रांसफ़ॉर्मेशन रेसिपी का एक व्यापक पुस्तकालय प्रदान करता है जिसमें शून्य कोडिंग की आवश्यकता होती है।
एकीकृत ML वर्कफ़्लो (Integrated ML Workflows): उसी वातावरण के भीतर साफ किए गए डेटा को सीधे मशीन लर्निंग मॉडल प्रशिक्षण में आसानी से स्थानांतरित करता है।
फायदे
विविध टीमों के लिए उत्कृष्ट सहयोग सुविधाएँ।
शुरुआती लोगों के लिए विज़ुअल UI और विशेषज्ञों के लिए कोडिंग वातावरण दोनों प्रदान करता है।
विशाल उद्यम डेटासेट के लिए अत्यधिक स्केलेबल।
नुकसान
उन उपयोगकर्ताओं के लिए भारी पड़ सकता है जिन्हें केवल साधारण डेटा सफाई की आवश्यकता होती होती है।
छोटे व्यवसायों के लिए एंटरप्राइज मूल्य निर्धारण अत्यधिक निषेधात्मक हो सकता है।
मूल्य निर्धारण
परिनियोजन (deployment) आकार और उपयोगकर्ता संख्या के आधार पर कस्टम एंटरप्राइज मूल्य निर्धारण।
3. Alteryx
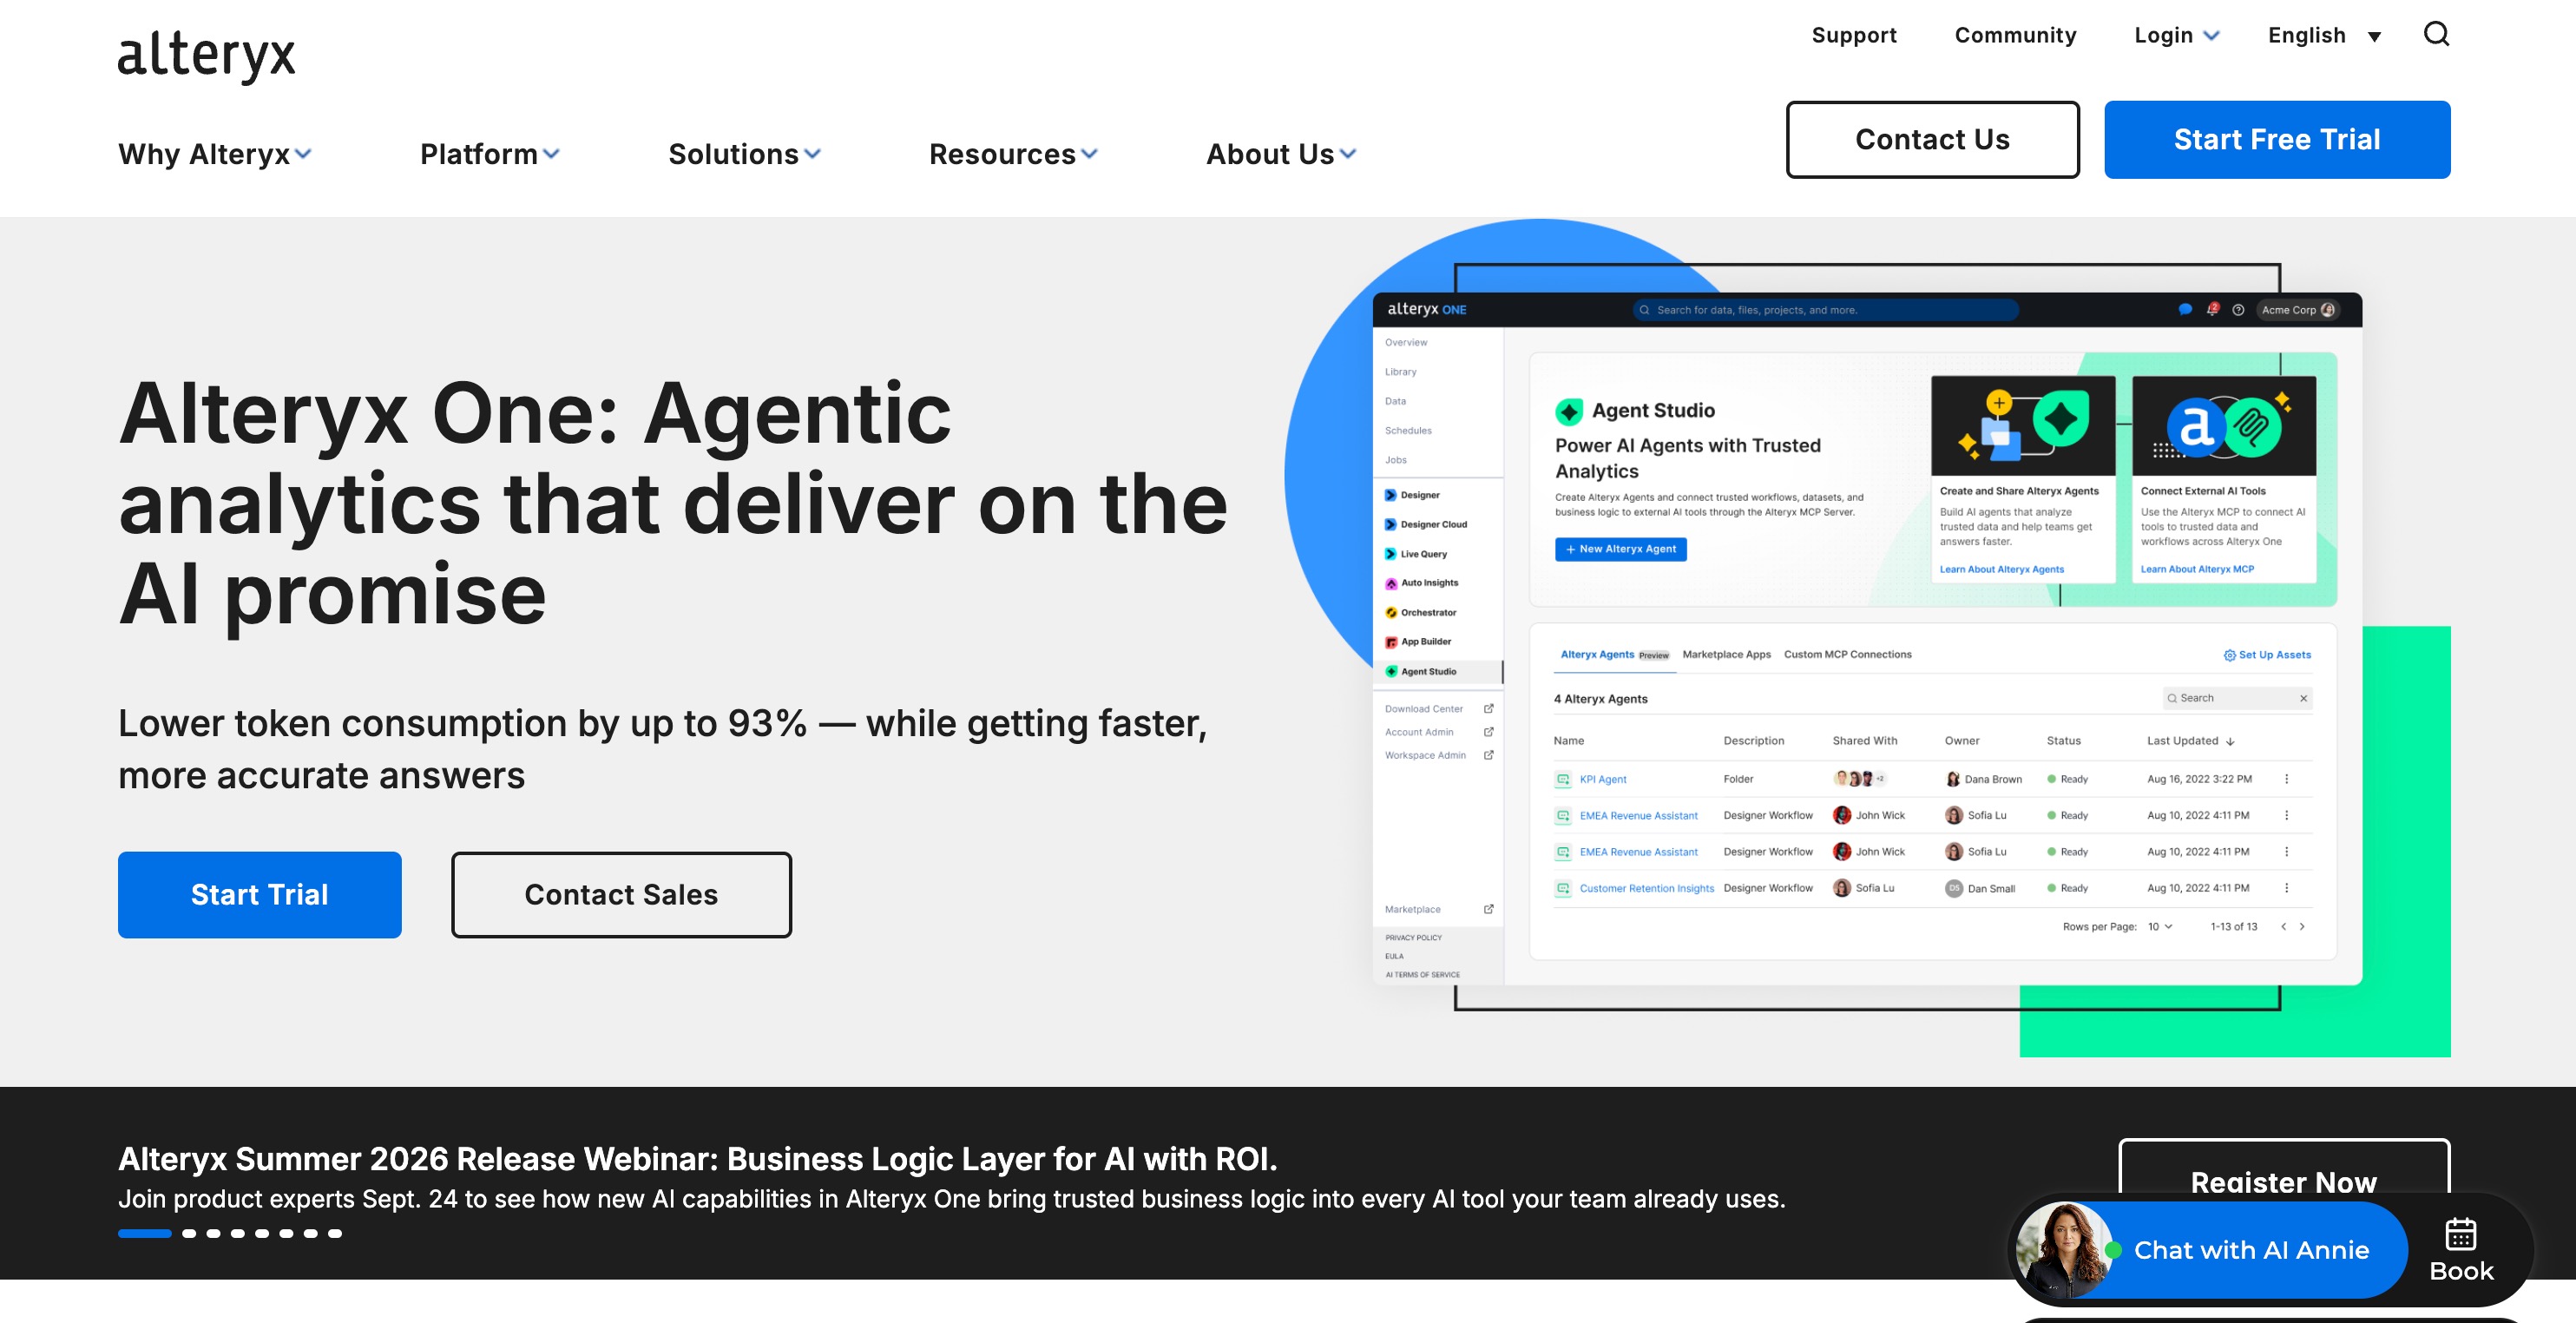
Alteryx स्वचालित डेटा एनालिटिक्स क्षेत्र में एक उद्योग दिग्गज है। यह विश्लेषकों को डेटा को जल्दी से तैयार करने, मिश्रित करने और विश्लेषण करने में सक्षम बनाने पर भारी ध्यान केंद्रित करता है। अपने शक्तिशाली ड्रैग-एंड-ड्रॉप वर्कफ़्लो डिज़ाइनर के लिए जाना जाने वाला, Alteryx डेटा सफाई को अत्यधिक कुशल बनाने के लिए परिष्कृत AI प्रोफाइलिंग को एकीकृत करता है।
मुख्य विशेषताएं
स्वचालित डेटा प्रोफाइलिंग (Automated Data Profiling): डेटा स्वास्थ्य, लापता मानों और बाहरी कड़ियों (outliers) का त्वरित विज़ुअल सारांश देता है।
स्थानिक डेटा सम्मिश्रण (Spatial Data Blending): भौगोलिक और स्थानिक डेटासेट की सफाई और विलय के लिए उन्नत क्षमताएं।
पूर्वानुमानित वर्कफ़्लो (Predictive Workflows): उपयोगकर्ता के व्यवहार और डेटा पैटर्न के आधार पर अगले सर्वोत्तम परिवर्तन चरण का सुझाव देता है।
फायदे
सकड़ों विभिन्न डेटा स्रोतों में अविश्वसनीय रूप से शक्तिशाली डेटा सम्मिश्रण।
सहज ज्ञान युक्त ड्रैग-एंड-ड्रॉप कैनवास जटिल ETL प्रक्रियाओं को विज़ुअल बनाता है।
मजबूत समुदाय और व्यापक दस्तावेज।
नुकसान
लाइसेंसिंग लागत उद्योग में सबसे अधिक है।
डेस्कटॉप संस्करणों पर महत्वपूर्ण स्थानीय कंप्यूटिंग संसाधनों की खपत कर सकता है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
4. Matillion
Matillion एक क्लाउड-नेटिव डेटा एकीकरण और परिवर्तन प्लेटफ़ॉर्म है जिसे विशेष रूप से Snowflake, Amazon Redshift और Google BigQuery जैसे क्लाउड डेटा वेयरहाउस के लिए डिज़ाइन किया गया है। यह Extract, Load, Transform (ELT) प्रक्रिया को अनुकूलित करने के लिए AI का उपयोग करता है, जिससे यह सुनिश्चित होता है कि डेटा वेयरहाउस में जाने से पहले साफ हो।
मुख्य विशेषताएं
पुश-डाउन AI प्रोसेसिंग (Push-down AI Processing): विशाल डेटासेट को जल्दी से साफ करने के लिए क्लाउड डेटा वेयरहाउस की प्रोसेसिंग शक्ति का उपयोग करता है।
AI-संचालित घटक मैपिंग (AI-Driven Component Mapping): विभिन्न APIs से डेटा संरचनाओं और स्कीमा को स्वचालित रूप से मैप करता है।
विज़ुअल जॉब ऑर्केस्ट्रेशन (Visual Job Orchestration): उपयोगकर्ता जटिल डेटा सफाई पाइपलाइनों को विज़ुअल रूप से बना सकते हैं।
फायदे
क्लाउड डेटा वेयरहाउस के साथ जोड़े जाने पर बेजोड़ प्रदर्शन।
अत्यधिक स्वचालित शेड्यूलिंग और निर्भरता प्रबंधन।
आधुनिक SaaS उपकरणों के लिए बेहतरीन API एकीकरण।
नुकसान
क्लाउड आर्किटेक्चर से अपरिचित उपयोगकर्ताओं के लिए कठिन सीखने की प्रक्रिया।
स्थानीय या डेस्कटॉप-आधारित डेटा सफाई कार्यों के लिए उपयुक्त नहीं है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
5. Integrate.io
Integrate.io एक डेटा वेयरहाउस एकीकरण प्लेटफ़ॉर्म है जिसे ई-कॉमर्स, मार्केटिंग और बिक्री डेटा के लिए ETL प्रक्रियाओं को सरल बनाने के लिए डिज़ाइन किया गया है। इट यूटिलाइज़ेस AI टू हेल्प नॉन-टेक्निकल यूज़र्स बिल्ड डेटा पाइपलाइन्स, जिससे यह सुनिश्चित होता है कि रिपोर्टिंग के लिए उपयोग किए जाने से पहले डेटा मानकीकृत और साफ हो।
मुख्य विशेषताएं
स्मार्ट स्कीमा पहचान (Smart Schema Recognition): AI आने वाले डेटा प्रारूपों का पता लगाता है और लक्षित स्कीमा को स्वचालित रूप से समायोजित करता है।
पूर्व-निर्मित रूपांतरण (Pre-built Transformations): 100 से अधिक आउट-ऑफ-द-बॉक्स डेटा सफाई कार्य प्रदान करता है।
रिवर्स ETL (Reverse ETL): उपयोगकर्ताओं को साफ किए गए डेटा को वापस परिचालन उपकरणों जैसे CRMs में धकेलने की अनुमति देता है।
फायदे
मार्केटिंग और ई-कॉमर्स टीमों के लिए बहुत उपयोगकर्ता के अनुकूल।
उत्कृष्ट ग्राहक सहायता और सीधी ऑनबोर्डिंग।
नो-कोड इंटरफ़ेस परिनियोजन (deployment) के समय को गति देता है।
नुकसान
एंटरप्राइज डेटा साइंस प्लेटफॉर्म की गहरी मशीन लर्निंग क्षमताओं का अभाव है।
असाधारण रूप से बड़े ऐतिहासिक डेटासेट के साथ रूपांतरण की गति कम हो सकती है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
6. Tamr
Tamr मास्टर डेटा प्रबंधन (MDM) पर ध्यान केंद्रित करके डेटा तैयारी के लिए एक अत्यधिक विशिष्ट दृष्टिकोण अपनाता है। यह कई अलग-अलग प्रणालियों से अव्यवस्थित डेटा को समेकित, स्वच्छ और वर्गीकृत करने के लिए मशीन लर्निंग मॉडल का उपयोग करता है, जिससे संगठनों के लिए एक एकल "गोल्डन रिकॉर्ड" बनता है।
मुख्य विशेषताएं
मानव-निर्देशित मशीन लर्निंग (Human-Guided Machine Learning): AI समय के साथ अपने डीडुप्लीकेशन और वर्गीकरण सटीकता को बेहतर बनाने के लिए मानव प्रतिक्रिया से सीखता है।
फ़ज़ी मैचिंग (Fuzzy Matching): उन्नत एल्गोरिदम डुप्लिकेट का पता लगाते हैं, भले ही टाइपो, विभिन्न प्रारूप या लापता फ़ील्ड हों।
सतत डेटा गुणवत्ता (Continuous Data Quality): यह सुनिश्चित करने के लिए आने वाले डेटा की स्वचालित रूप से निगरानी करता है कि यह स्वच्छता मानकों को पूरा करता है।
फायदे
एंटरप्राइज डेटा डीडुप्लीकेशन के लिए बाजार में सबसे अच्छा उपकरण।
मैन्युअल डेटा मास्टरिंग प्रयासों को 90% तक कम करता है।
खंडित डेटा वाले वैश्विक उद्यमों के लिए अत्यधिक स्केलेबल।
नुकसान
सेटअप और मॉडल प्रशिक्षण के लिए महत्वपूर्ण प्रारंभिक समय निवेश की आवश्यकता होती है।
पूरी तरह से एक एंटरप्राइज टूल है, जो छोटी टीमों के दायरे से पूरी तरह बाहर है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
7. Datameer
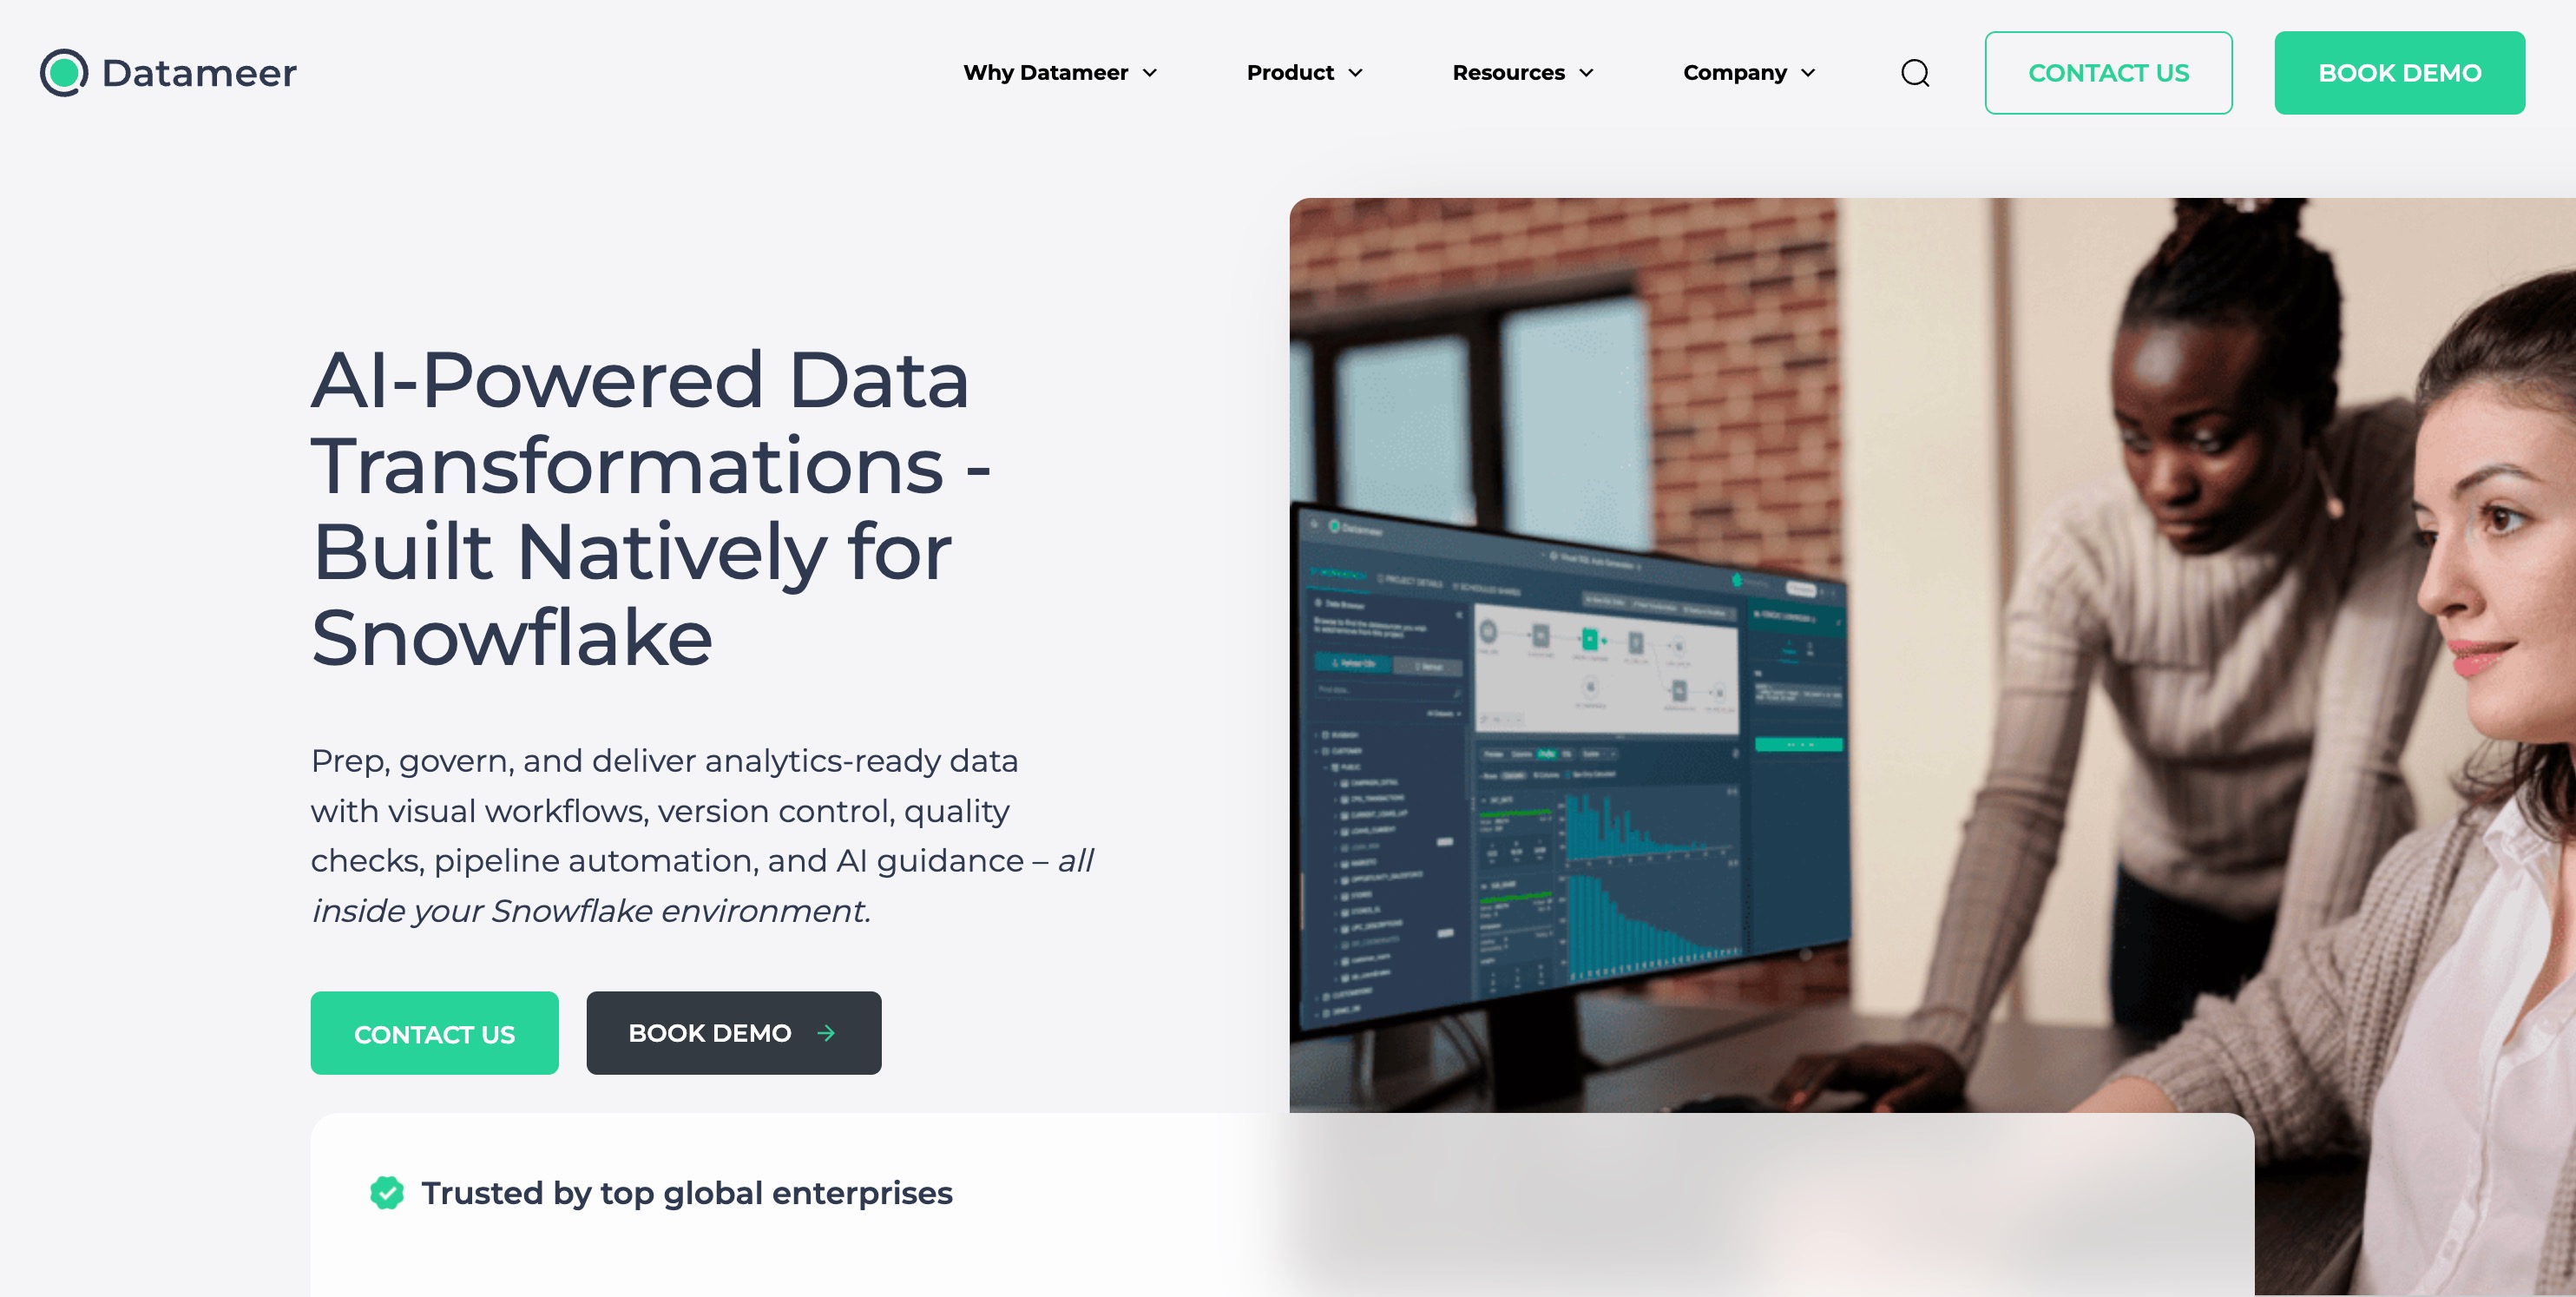
Datameer एक SaaS डेटा ट्रांसफ़ॉर्मेशन प्लेटफ़ॉर्म है जिसे विशेष रूप से Snowflake के लिए बनाया गया है। यह स्प्रेडशीट-जैसे इंटरफ़ेस और उन्नत SQL कार्यात्मकताओं दोनों की पेशकश करके आम लोगों के लिए AI-सहायता प्राप्त डेटा इंजीनियरिंग लाता है, जिससे उपयोगकर्ता अपने डेटा को आसानी से साफ और आकार दे सकते हैं।
मुख्य विशेषताएं
AI SQL Copilot: सरल अंग्रेजी अनुरोधों के आधार पर डेटा सफाई के लिए जटिल SQL प्रश्नों को स्वचालित रूप से उत्पन्न करने के लिए AI का उपयोग करता है।
मल्टी-पर्सोना UI (Multi-Persona UI): एक साथ विज़ुअल, स्प्रेडशीट और कोड इंटरफेस प्रदान करता है।
डेटा वंशावली ट्रैकिंग (Data Lineage Tracking): स्वचालित रूप से विज़ुअलाइज़ करता है कि स्रोत से गंतव्य तक डेटा को कैसे रूपांतरित और साफ किया गया है।
फायदे
Snowflake इकोसिस्टम के साथ सही तालमेल।
तकनीकी इंजीनियरों और व्यावसायिक विश्लेषकों के बीच की खाई को पाटता है।
अत्यधिक पारदर्शी रूपांतरण चरण।
नुकसान
Snowflake के साथ कसकर जुड़ा हुआ है; अन्य डेटा वेयरहाउस के लिए सीमित उपयोगिता।
सरल, एक बार के फ़ाइल सफाई कार्यों के लिए बहुत अधिक हो सकता है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
8. KNIME
KNIME (Konstanz Information Miner) एक शक्तिशाली, ओपन-सोर्स एनालिटिक्स प्लेटफ़ॉर्म है। यह उपयोगकर्ताओं को विज़ुअल रूप से डेटा प्रवाह बनाने, चुनिंदा रूप से विश्लेषण चरणों को निष्पादित करने और परिणामों का निरीक्षण करने की अनुमति देता है। अपने एक्सटेंशन के माध्यम से, यह गहरे डेटा स्क्रबिंग और माइनिंग के लिए AI और मशीन लर्निंग का लाभ उठाता है।
मुख्य विशेषताएं
विज़ुअल नोड कैनवास (Visual Node Canvas): उपयोगकर्ता विभिन्न ट्रांसफ़ॉर्मेशन नोड्स को एक साथ जोड़कर डेटा साफ करते हैं।
व्यापक AI एकीकरण (Extensive AI Integration): उन्नत AI डेटा हेरफेर के लिए H2O, Keras और TensorFlow के साथ एकीकरण का समर्थन करता है।
सामुदायिक एक्सटेंशन (Community Extensions): विशिष्ट डेटा सफाई कार्यों के लिए हजारों पूर्व-निर्मित, समुदाय-साझा नोड्स।
फायदे
डेस्कटॉप संस्करण के लिए मुफ्त और ओपन-सोर्स।
अविश्वसनीय रूप से बहुमुखी; लगभग किसी भी डेटा प्रारूप या सफाई की आवश्यकता को संभाल सकता है।
मजबूत वैश्विक सामुदायिक समर्थन।
नुकसान
आधुनिक SaaS प्लेटफार्मों की तुलना में इंटरफ़ेस पुराना और अनाड़ी लगता है।
नोड कॉन्फ़िगरेशन को समझने के लिए काफी सीखने की प्रक्रिया की आवश्यकता होती है।
मूल्य निर्धारण
कस्टम मूल्य निर्धारण।
9. Zoho DataPrep
Zoho DataPrep एक उन्नत, स्व-सेवा डेटा तैयारी प्लेटफ़ॉर्म है जो Zoho के बुद्धिमान AI सहायक, Zia द्वारा संवर्धित है। व्यावसायिक उपयोगकर्ताओं और डेटा पेशेवरों दोनों को सशक्त बनाने के लिए डिज़ाइन किया गया, यह कच्चे डेटा को एनालिटिक्स, मशीन लर्निंग और माइग्रेशन के लिए तैयार करने के लिए निर्बाध रूप से जोड़ता है, साफ करता है, रूपांतरित करता है और समृद्ध करता है। यह न्यूनतम मैन्युअल हस्तक्षेप के साथ अराजक, असंरचित डेटासेट को प्राचीन, व्यावहारिक संपत्तियों में बदलने में उत्कृष्टता प्राप्त करता है।
मुख्य विशेषताएं
AI-संचालित ऑटो-क्लींजिंग (AI-Powered Auto-Cleansing): Zia विसंगतियों का पता लगाने, डेटा प्रकारों की पहचान करने और प्रासंगिक स्वरूपण (formatting) परिवर्तनों का सुझाव देने के लिए आने वाले डेटासेट का स्वचालित रूप से विश्लेषण करती है।
स्मार्ट डेटा संवर्धन (Smart Data Enrichment): टेक्स्ट कॉलम पर स्वचालित रूप से कीवर्ड निकालने, भाषाओं का पता लगाने और भावना विश्लेषण (sentiment analysis) करने के लिए अंतर्निहित natural language processing (NLP) का लाभ उठाता है।
व्यापक डेटा प्रोफाइलिंग (Comprehensive Data Profiling): डेटा गुणवत्ता के सहज विज़ुअल संकेतक प्रदान करता है, जो एक गतिशील डैशबोर्ड पर लापता मानों, डुप्लिकेट और अमान्य रिकॉर्ड को तुरंत उजागर करता है।
फायदे
अत्यधिक सहज ज्ञान युक्त, स्प्रेडशीट-जैसा इंटरफ़ेस जिसमें कोडिंग ज्ञान की बिल्कुल भी आवश्यकता नहीं होती है।
व्यापक Zoho इकोसिस्टम (Zoho Analytics, Zoho CRM, आदि) और 50 से अधिक तृतीय-पक्ष अनुप्रयोगों के साथ निर्बाध, मूल एकीकरण।
उत्कृष्ट बुद्धिमान संवर्धन उपकरण जो बुनियादी टेक्स्ट डेटा में गहरा संदर्भ जोड़ते हैं।
नुकसान
इसका अधिकतम वर्कफ़्लो मूल्य इस बात से भारी रूप से जुड़ा हुआ है कि क्या आप पहले से ही अन्य Zoho सुइट उत्पादों का उपयोग करते हैं।
क्लाउड-नेटिव ELT उपकरणों की तुलना में बड़े, उद्यम-स्तरीय डेटासेट को संभालते समय प्रसंस्करण गति कभी-कभी धीमी हो सकती है।
मूल्य निर्धारण
$50/माह।
10. Tableau Prep
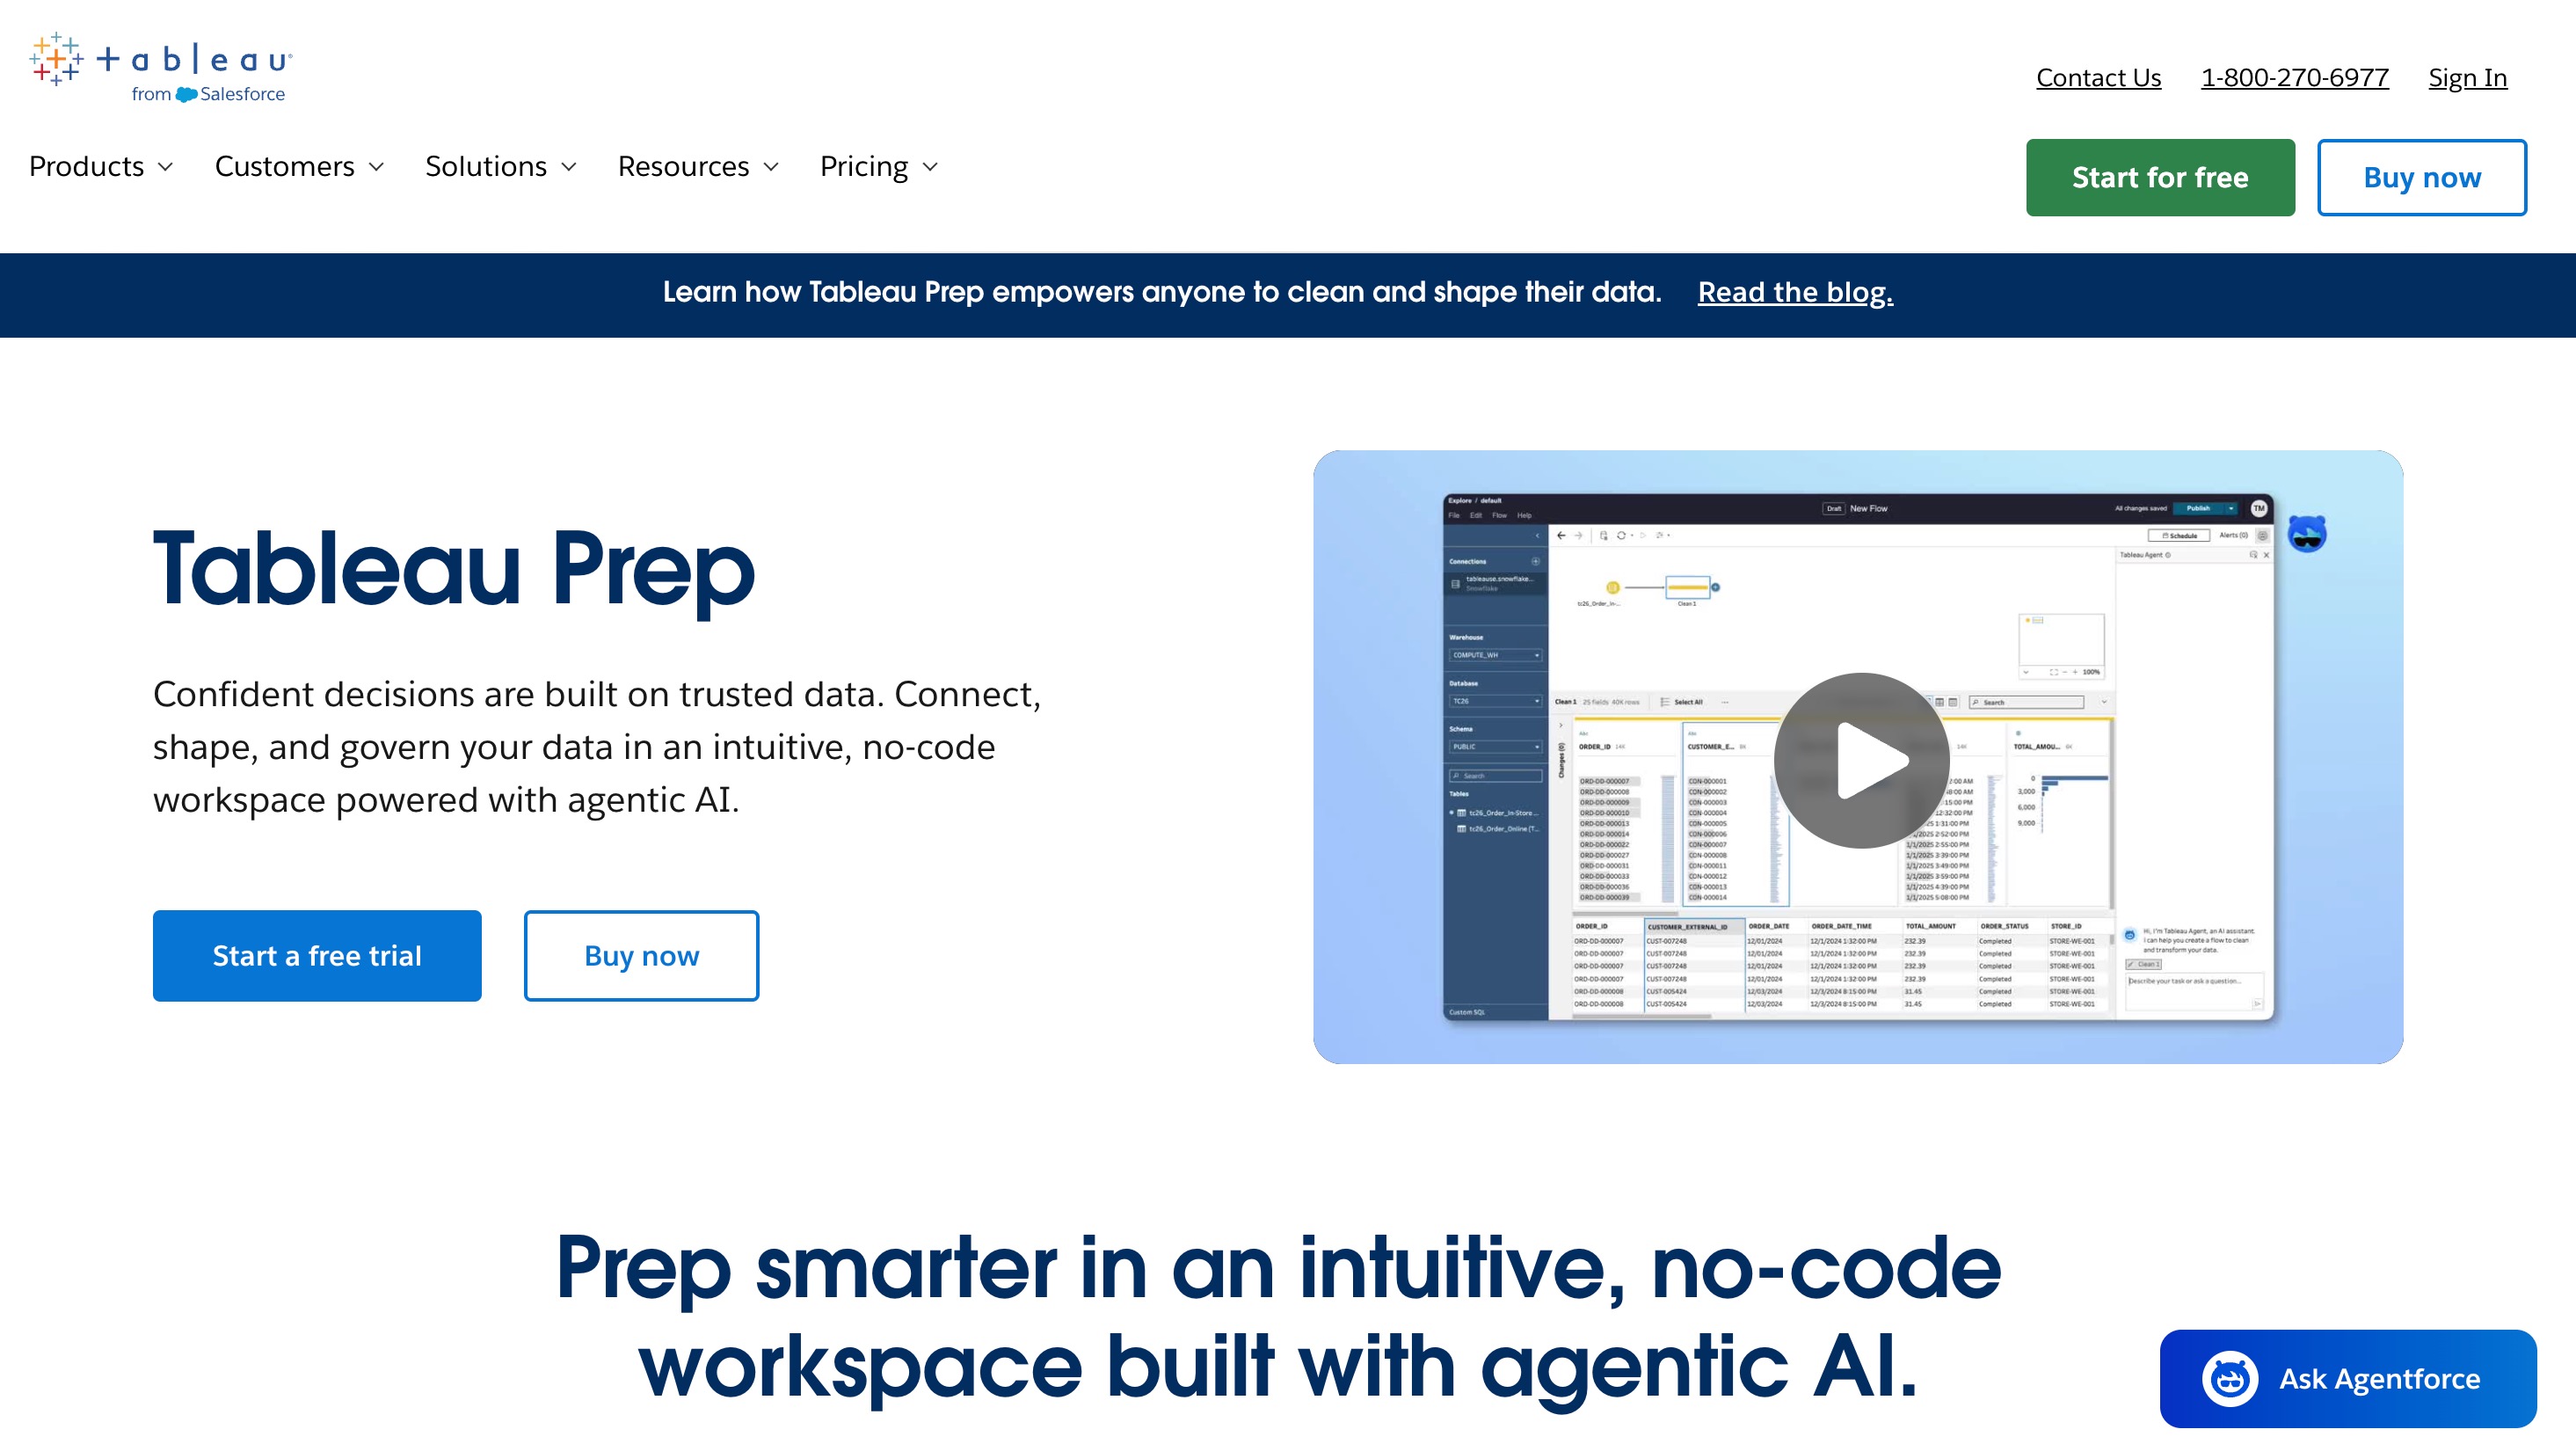
Tableau Prep को डेटा तैयारी को विज़ुअल, प्रत्यक्ष और स्मार्ट बनाकर Tableau उपयोगकर्ता आधार को सशक्त बनाने के लिए डिज़ाइन किया गया है। यह उपयोगकर्ताओं को उन्नत विज़ुअल एनालिटिक्स के लिए Tableau में भेजने से पहले अपने डेटा को संयोजित करने, आकार देने और साफ करने में मदद करने के लिए बुद्धिमान एल्गोरिदम का उपयोग करता है।
मुख्य विशेषताएं
स्मार्ट ग्रुप और रिप्लेस (Smart Group and Replace): AI समान मानों (जैसे, एक ही शहर की गलत वर्तनी) को स्वचालित रूप से समूहित करता है।
विज़ुअल प्रोफाइलिंग (Visual Profiling): डेटा वितरण और विसंगतियों पर वास्तविक समय विज़ुअल फीडबैक।
निर्बाध Tableau एकीकरण (Seamless Tableau Integration): साफ किए गए डेटासेट को एक क्लिक के साथ सीधे Tableau Server या Cloud पर प्रकाशित किया जा सकता है।
फायदे
अत्यधिक सहज और विज़ुअल, विश्लेषकों के लिए एकदम सही।
Tableau Creator लाइसेंस के भीतर मूल रूप से शामिल है।
विशेष रूप से डैशबोर्डिंग के लिए डेटा तैयार करने के लिए उत्कृष्ट।
नुकसान
यदि आप अपने प्राथमिक BI टूल के रूप में Tableau का उपयोग नहीं करते हैं तो सीमित कार्यक्षमता।
अत्यधिक जटिल, बहु-स्तरीय ETL पाइपलाइनों के साथ संघर्ष करता है।
मूल्य निर्धारण
$15/माह।
AI डेटा क्लीनिंग में क्या स्वचालित कर सकता है
AI डेटा तैयारी को मैन्युअल काम से स्वचालित वर्कफ़्लो में नाटकीय रूप से बदल देता है। यहाँ बिल्कुल वही है जो AI आपके हाथों से ले सकता है:
लापता मानों को संभालना (Handling Missing Values): मैन्युअल रूप से पंक्तियों को हटाने के बजाय, AI आसपास के संदर्भ के आधार पर लापता डेटा को सटीक रूप से भरने के लिए पूर्वानुमानित मॉडलिंग का उपयोग करता है।
बाहरी कड़ियों की पहचान (Outlier Detection): AI सांख्यिकीय विसंगतियों और बाहरी कड़ियों (outliers) को चिह्नित करने के लिए लगातार डेटासेट की निगरानी करता है जो आपकी रिपोर्टिंग को प्रभावित कर सकते हैं।
स्वरूपण और मानकीकरण (Formatting and Standardization): AI लाखों पंक्तियों में तिथियों, मुद्राओं और टेक्स्ट केस को तुरंत मानकीकृत करता है, जिससे एकरूपता सुनिश्चित होती है।
स्कीमा मैपिंग (Schema Mapping): विभिन्न स्रोतों से डेटा को मर्ज करते समय, AI मैन्युअल मैपिंग की आवश्यकता के बिना हेडर और कॉलम को स्वचालित रूप से संरेखित करता है।
डीडुप्लीकेशन (Deduplication): AI फ़ज़ी लॉजिक का उपयोग करके डुप्लिकेट प्रविष्टियों की पहचान करता है और उन्हें मर्ज करता है, यह पहचानते हुए कि "John Doe Inc." और "J. Doe Incorporated" एक ही इकाई हैं।
सही AI डेटा क्लीनिंग टूल कैसे चुनें
सही प्लेटफ़ॉर्म का चयन पूरी तरह से आपकी टीम के कौशल, बजट और विशिष्ट डेटा आवश्यकताओं पर निर्भर करता है। इन बातों को ध्यान में रखें:
अपनी तकनीकी विशेषज्ञता का आकलन करें (Assess Your Technical Expertise): KNIME और Alteryx जैसे उपकरण अविश्वसनीय गहराई प्रदान करते हैं, लेकिन उन्हें सीखने की एक कठिन प्रक्रिया और डेटा लॉजिक की तकनीकी समझ की आवश्यकता होती है। यदि आप शून्य-सीखने-की-प्रक्रिया वाला समाधान चाहते हैं, तो Powerdrill Bloom रोज़मर्रा की भाषा का उपयोग करके संवादात्मक रूप से डेटा को साफ करने की अनुमति देकर सबसे अलग दिखता है।
अपने वर्कफ़्लो के दायरे पर विचार करें (Consider the Scope of Your Workflow): क्या आप केवल डेटा साफ कर रहे हैं, या आपको इसे प्रस्तुत करने की आवश्यकता है? यदि आप Tableau का उपयोग करते हैं तो Tableau Prep बहुत अच्छा है, और Snowflake के लिए Datameer उत्कृष्ट है। हालाँकि, Powerdrill Bloom की अत्यधिक अनुशंसा की जाती है क्योंकि यह एक ऑल-इन-वन वर्कस्पेस के रूप में कार्य करता है—जो आपको सीधे raw CSV फ़ाइलों से साफ किए गए डेटा, विज़ुअल विश्लेषण और अंतिम प्रस्तुति-तैयार रिपोर्ट तक ले जाता है।
संदर्भ और मेमोरी का मूल्यांकन करें (Evaluate Context and Memory): अधिकांश उपकरण प्रत्येक डेटा अपलोड को एक खाली स्लेट के रूप में मानते हैं। Powerdrill Bloom अपने MemoryLake एकीकरण के साथ अद्वितीय है, जो आपके वर्कफ़्लो, प्रोजेक्ट संदर्भ और पिछली प्राथमिकताओं की एक स्थायी मेमोरी बनाए रखता है, जिससे आवर्ती कार्यों पर भारी समय बचता है।
बजट पर नज़र डालें (Look at the Budget): Tamr और Dataiku जैसे एंटरप्राइज उपकरण शक्तिशाली हैं लेकिन भारी कीमत के साथ आते हैं जो केवल बड़े निगमों के लिए उपयुक्त हैं। OpenRefine मुफ्त है लेकिन इसमें आधुनिक AI का अभाव है। Powerdrill Bloom अत्यधिक सुलभ मूल्य निर्धारण स्तरों पर एंटरप्राइज-ग्रेड AI स्वचालन की पेशकश करते हुए सही संतुलन बनाता है।
अंतिम निर्णय
जबकि बाजार विशिष्ट क्षेत्रों के लिए मजबूत उपकरणों से भरा हुआ है—जैसे कि भारी विश्लेषकों के लिए Alteryx या विशाल उद्यम MDM के लिए Tamr—डेटा सफाई का भविष्य पहुंच, स्वचालन और एंड-टू-एंड कार्यक्षमता में निहित है। Powerdrill Bloom 2026 के लिए हमारी शीर्ष अनुशंसा है। AI-संचालित विसंगति पहचान की शक्ति और एक स्थायी MemoryLake के साथ natural language processing की आसानी को जोड़कर, यह डेटा तैयारी से घर्षण को दूर करता है। केवल आपके डेटा को साफ करने के बजाय, Powerdrill Bloom एक सच्चे बुद्धिमान भागीदार के रूप में कार्य करता है, जो आपको एक एकीकृत वर्कस्पेस में अराजक raw फ़ाइलों से पॉलिश की गई, व्यावहारिक अंतर्दृष्टि तक निर्बाध रूप से ले जाता है।
अक्सर पूछे जाने वाले प्रश्न (FAQs)
1. AI डेटा क्लीनिंग क्या है?
AI डेटा क्लीनिंग अव्यवस्थित डेटासेट त्रुटियों का स्वचालित रूप से पता लगाने, प्रारूपित करने और ठीक करने के लिए मशीन लर्निंग और natural language processing का उपयोग करता है।
2. क्या मैं कोडिंग कौशल के बिना डेटा साफ कर सकता हूँ?
बिल्कुल। Powerdrill Bloom जैसे आधुनिक AI प्लेटफ़ॉर्म आपको सरल प्राकृतिक भाषा कमांड का उपयोग करके डेटा तैयार करने और साफ करने की अनुमति देते हैं।
3. AI लापता डेटा मानों (missing data values) को कैसे संभालता है?
AI एल्गोरिदम बुद्धिमानी से लापता मानों की भविष्यवाणी करने और उन्हें प्रतिस्थापित (impute) करने के लिए आसपास के डेटा पैटर्न का विश्लेषण करते हैं, जिससे सटीक और पूर्ण डेटासेट सुनिश्चित होते हैं।
4. मुझे Powerdrill Bloom क्यों चुनना चाहिए?
यह प्राकृतिक भाषा डेटा क्लीनिंग, गहन विश्लेषण और स्थायी मेमोरी को एक अत्यधिक कुशल, उपयोगकर्ता के अनुकूल वर्कस्पेस में निर्बाध रूप से जोड़ता है।
5. क्या AI डेटा क्लीनिंग टूल्स सुरक्षित हैं?
हाँ, प्रतिष्ठित उपकरण यह सुनिश्चित करने के लिए एंटरप्राइज-ग्रेड एन्क्रिप्शन और अनुपालन प्रोटोकॉल का उपयोग करते हैं कि आपका संवेदनशील व्यावसायिक डेटा पूरी तरह से सुरक्षित रहे।